

UMI 人类演示数据处理
概述
将 UMI(Universal Manipulation Interface)手持夹爪采集的 GoPro 演示视频,重建为包含图像、末端(TCP)位姿和夹爪开合宽度的 Zarr 数据集,同时为每段演示(episode)生成任务描述(caption)和子任务分段(subtask)候选。
- 输入:收件箱目录。每个子目录是一个采集会话(session),包含 1 段建图视频、至少 1 段夹爪标定视频和若干段演示视频。
- 输出:每个 session 一份 Zarr 数据集
dataset.zarr.zip、数据集规划dataset_plan.pkl、质量报告和语义标注结果;每个批次一份交付清单manifest.jsonl和完成标记_SUCCESS.json。 -
业务价值:UMI 采集不需要机器人本体,单人手持即可完成示教,成本低、易于多人多地并行。本管线把建图定位、标定、对齐、语义标注和质检串成一条工作流:
- 放入即处理:自动识别收件箱中的 session,无需逐个配置。
- 并行处理:视频和 episode 在 Worker 间流式并行;数据集生成与语义标注两个分支同时运行。以示例数据为例,3 个 session(每个 5 段演示)从提交到完成约 27 分钟。
- 结果可追溯:每个批次绑定镜像代码、配置和输入文件的 SHA256,每个产物记录大小和 SHA256。
说明:本模板不包含目标机器人重定向、LeRobot 格式转换、模型训练和实机执行。
处理前后示例
输入为一段原始 GoPro 视频,处理后得到 224×224 的图像序列、整段描述和分段描述。下图为同一段演示处理前后的画面及对应描述。
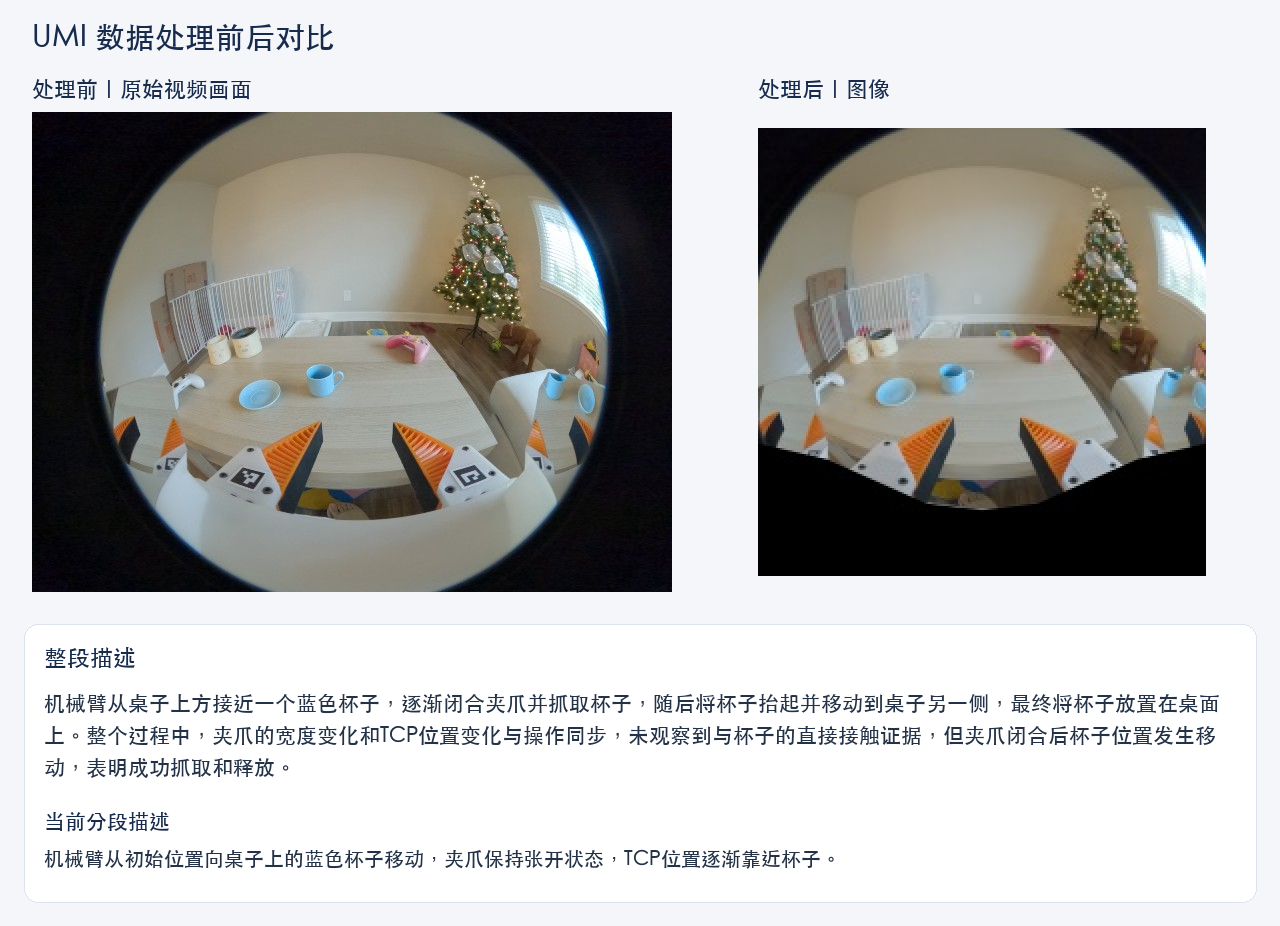 整段描述
机械臂从桌子上方接近一个蓝色杯子,逐渐闭合夹爪并抓取杯子,随后将杯子抬起并移动到桌子另一侧,最终将杯子放置在桌面上。整个过程中,夹爪的宽度变化和TCP位置变化与操作同步,未观察到与杯子的直接接触证据,但夹爪闭合后杯子位置发生移动,表明成功抓取和释放。
分段描述(第 1 段)
机械臂从初始位置向桌子上的蓝色杯子移动,夹爪保持张开状态,TCP位置逐渐靠近杯子。 以上描述为模型生成的原文。语义结果属于候选,使用前需人工审核。
处理流程
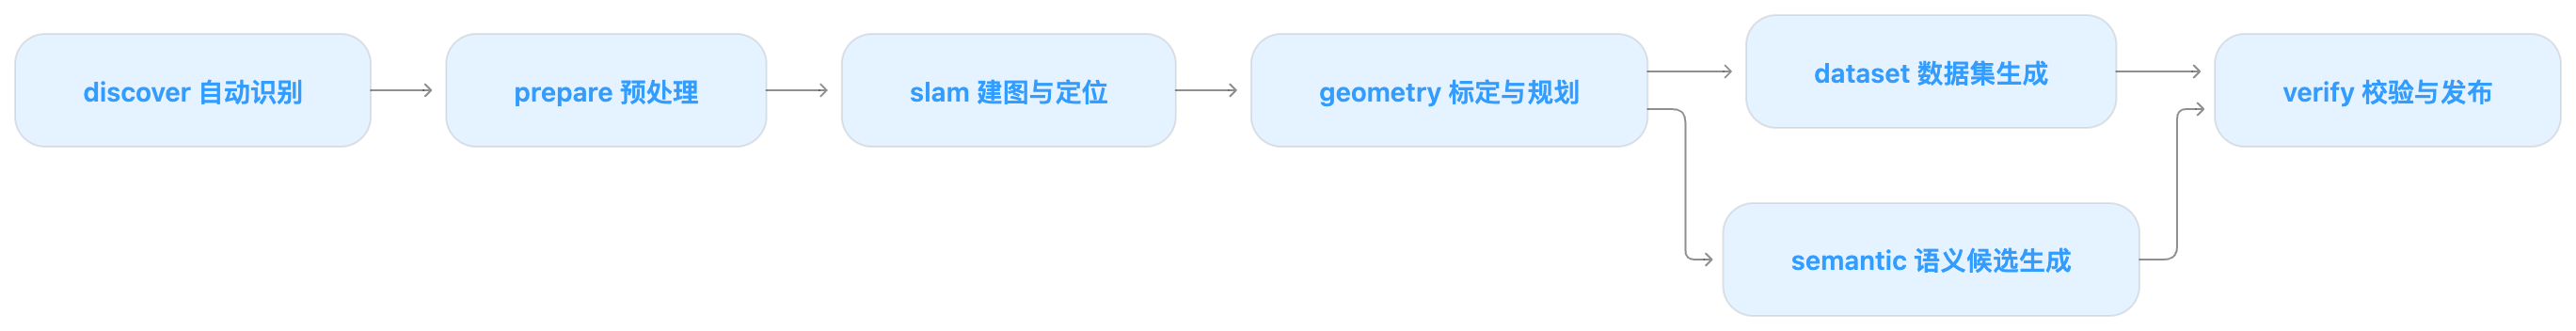
1原始 GoPro 视频(收件箱)
2  → S1 discover  自动识别 session,生成输入清单
3  → S2 prepare   整理视频,提取 IMU
4  → S3 slam      建图,逐视频定位
5  → S4 geometry  标记检测、标定、数据集规划
6  → S5 dataset   生成 Zarr 数据集        ┐
7  → S6 semantic  生成语义候选(GPU)      ┘ 两者并行
8  → S7 verify    汇总质量报告,发布交付物
S5 dataset 与 S6 semantic 都只依赖 S4 geometry,两者并行执行;S7 verify 在两者都完成后执行。
算子映射
| 步骤 | 节点 | 主要算子 | 说明 |
|---|---|---|---|
| S1 | discover | discover.sh |
扫描收件箱,生成输入清单 |
| S2 | prepare | umi_mapper_prepare_session |
整理视频,提取 GoPro IMU |
| S3 | slam | umi_mapper_create_mapumi_mapper_slam_video |
ORB-SLAM3 建图与定位 |
| S4 | geometry | umi_mapper_detect_arucoumi_mapper_calibrate_sessionumi_mapper_dataset_plan |
ArUco 检测、标定、规划 |
| S5 | dataset | umi_mapper_replay_bufferumi_mapper_verify_dataset |
生成并校验 Zarr |
| S6 | semantic | umi_mapper_semantic_prepareumi_mapper_vlm_annotateumi_mapper_semantic_summary |
抽帧、模型标注、汇总 |
| S7 | verify | umi_mapper_verify_report |
合并质量报告,发布 |
S2~S7 每一步结束时由 umi_mapper_record_artifacts 记录产物的路径、大小和 SHA256,下游步骤开始前会先校验这些记录。各步骤的完整算子链由镜像内的 configs/<步骤>.yaml 定义。
数据流向
所有产物写在同一个批次目录下,批次目录由 batch_tag 决定:
1<inbox>/<session_id>/raw_videos/            原始视频
2  → S1 discover   /mnt/data/umi/deployments/umi-<batch_tag>/{runtime.json, inputs.jsonl}
3  → S2 prepare    runs/<batch_tag>/sessions/<session_id>/demos/*/{raw_video.mp4, imu_data.json}
4  → S3 slam       demos/mapping/map_atlas.osa、demos/*/camera_trajectory.csv
5  → S4 geometry   demos/*/tag_detection.pkl、gripper_range.json、dataset_plan.pkl
6  → S5 dataset    dataset.zarr.zip、quality-report.json
7  → S6 semantic   semantic/{captions.jsonl, subtasks.jsonl, index.html, summary.json}
8  → S7 verify     verify/quality-report.json
9  → 发布          deliveries/<batch_tag>/verify-attempts/<attempt_id>/
10                  deliveries/<batch_tag>/verify/_SUCCESS.json
S2~S7 都在同一个 session 目录 runs/<batch_tag>/sessions/<session_id>/ 中追加产物,步骤之间不复制数据。
前置条件
| 资源 | 说明 |
|---|---|
| 资源池与队列 | 全托管资源池,已安装工作流组件 |
| GPU | S6 semantic 依赖 GPU,单卡显存不低于 24 GB(已验证 RTX 4090) |
| CPU | S1~S5、S7 为纯 CPU 步骤 |
| PFS 存储 | 收件箱、中间产物、交付物和模型缓存都在 PFS 上 |
| 镜像 | 〔待确认:公开镜像地址〕 |
| 模型权重 | Qwen3-VL-32B-Instruct,需预先放入模型缓存目录 |
| 标定文件 | 镜像内置 /opt/umi/example/calibration |
| 样例数据 | 〔待确认:公开样例数据入口〕 |
资源总量:S5 dataset 与 S6 semantic 并行运行,会同时申请资源。按默认参数,两者合计 60 核 CPU、368 GiB 内存、2 张 GPU。RayJob 按整组调度,队列空闲资源不足时整个任务排队,不会只启动一部分 Worker。提交前请确认队列空闲资源覆盖两者之和,并为 Submitter 预留少量资源。
模型权重:S6 semantic 离线加载 Qwen3-VL-32B-Instruct(4 bit 量化,单卡运行),不会在运行时下载。请提前将权重放到 PFS 上,使其在容器内的路径为 /mnt/data/umi/cache/semantic-models。〔待确认:权重目录的具体布局,例如是否为 Hugging Face 缓存格式。〕
标定文件:镜像内置的标定文件 gopro_intrinsics_2_7k.json 和 aruco_config.yaml 适用于下文“采集要求”中的 GoPro 与标记配置。相机型号、镜头模式或标记规格不同时,需要替换标定文件,示例标定不能直接用于其他采集设备。
输入说明
采集要求
| 项目 | 要求 |
|---|---|
| 相机 | GoPro,Max Lens 鱼眼模式(已验证 HERO9) |
| 视频规格 | 2.7K 4:3,2704×2028,59.94 fps |
| 元数据 | 保留 GPMF 惯导轨道、timecode、相机序列号和拍摄时间 |
| 夹爪标记 | ArUco DICT_4X4_50,ID 0/1,边长 0.016 m |
| 桌面标记 | ArUco ID 12~19,边长 0.16 m |
注意:请勿转码或剪辑原始 MP4,否则 IMU 和时间元数据会丢失,S2 无法提取惯导数据。
目录结构
收件箱的每个子目录表示一个 session,子目录名即 session_id:
1<inbox>/
2└── <session_id>/
3    └── raw_videos/
4        ├── mapping.mp4                     # 必需,建图视频
5        ├── gripper_calibration/
6        │   └── <标定视频>.MP4               # 必需,至少 1 个
7        ├── <演示视频 1>.MP4
8 └── <演示视频 2>.MP4- 建图视频:缓慢环绕桌面场景拍摄,用于建立 SLAM 地图。
- 夹爪标定视频:完整开合夹爪数次,用于标定开口范围。
- 演示视频:每段完成一次任务,生成一个或多个 episode。
S1 discover 会跳过不符合上述结构的子目录,并在日志中给出原因。运行后请在 discover 节点日志中核对识别出的 session 数量。
全局参数说明
| 参数名 | 类型 | 必填 | 默认值 | 说明 |
|---|---|---|---|---|
image |
string | 是 | 无 | UMI 工作流镜像地址 |
queue_id |
string | 是 | 无 | CPU 步骤队列 ID,格式 aihcq-xxxxxxxx |
gpu_queue_id |
string | 是 | 无 | S6 semantic 队列 ID,可与 queue_id 相同 |
priority |
string | 否 | normal |
任务优先级 |
pfs_id |
string | 是 | 无 | PFS 实例 ID,格式 pfs-xxxxxx |
pfs_source_path |
string | 否 | / |
PFS 内的源路径 |
pfs_mount_path |
string | 否 | /mnt/data |
容器内挂载路径,请勿修改 |
batch_tag |
string | 是 | 无 | 批次标识,每批数据使用新值 |
inbox |
string | 是 | 无 | 收件箱在容器内的绝对路径 |
head_cpu |
int | 否 | 4 |
CPU 步骤 Head 核数 |
head_memory |
int | 否 | 32 |
CPU 步骤 Head 内存(GiB) |
shared_memory |
int | 否 | 32 |
共享内存(GiB),不低于 16 |
worker_replicas |
int | 否 | 3 |
CPU Worker 数量 |
worker_cpu |
int | 否 | 12 |
单个 CPU Worker 核数,不低于 4 |
worker_memory |
int | 否 | 64 |
单个 CPU Worker 内存(GiB) |
gpu_worker_replicas |
int | 否 | 2 |
GPU Worker 数量 |
gpu_per_worker |
int | 否 | 1 |
单个 GPU Worker 的卡数 |
gpu_resource_name |
string | 是 | 无 | GPU 资源名,如 baidu.com/rtx_4090_cgpu |
gpu_head_cpu |
int | 否 | 4 |
S6 semantic Head 核数 |
gpu_head_memory |
int | 否 | 16 |
S6 semantic Head 内存(GiB) |
gpu_worker_cpu |
int | 否 | 8 |
单个 GPU Worker 核数,不低于 6 |
gpu_worker_memory |
int | 否 | 64 |
单个 GPU Worker 内存(GiB) |
thread_limit |
string | 否 | "1" |
计算库线程上限,建议 1~2 |
参数填写要点:
pfs_mount_path:运行配置和清单中使用的是/mnt/data开头的绝对路径,修改挂载路径会导致各步骤找不到文件。inbox也应填写/mnt/data下的路径,例如/mnt/data/umi/inbox/<目录名>。batch_tag:决定批次目录/mnt/data/umi/deployments/umi-<batch_tag>/。批次会绑定镜像代码、配置和输入文件,处理新数据或更换镜像时请使用新的batch_tag,例如20261113-run1。- CPU 资源:Head 只运行调度程序,不运行算子,算子都在 Worker 上执行。单个算子任务最多申请 4 核,因此
worker_cpu不能低于 4。数据量增大时,优先增加worker_replicas。 - GPU 资源:总卡数 =
gpu_worker_replicas×gpu_per_worker,每张卡运行一个模型实例。每个 GPU Worker 需同时容纳模型实例(2 核)和片段预处理(4 核),因此gpu_worker_cpu不能低于 6。模型加载到显存前会先读入内存,gpu_worker_memory建议保持 64。 thread_limit:OpenCV、FFmpeg、OpenMP、MKL 默认按物理核数开线程,容易超额占用 CPU。本参数通过环境变量传入各进程,以字符串形式填写。- 调整资源:资源申请量、算子实际占用和吞吐不成正比。修改 Worker 规格后,请同时核对队列空闲资源是否覆盖 S5 与 S6 两个任务之和。
以下处理配置由 S1 discover 写入 runtime.json,不作为全局参数开放:
| 配置 | 当前值 |
|---|---|
| 输出图像分辨率 | 224×224 |
| 语义抽帧数 | 每个 episode 20 帧 |
| 语义输出语言 | 中文 |
| 标定目录 | /opt/umi/example/calibration |
| 模型缓存目录 | /mnt/data/umi/cache/semantic-models |
步骤详解
S2~S7 启动后,Head 上的调度程序先校验批次绑定和上游产物(大小、SHA256),再按 configs/<步骤>.yaml 的算子链在 Worker 上流式执行。某一行(session、视频或 episode)出错时,该行被标记为失败并记录错误,其他行继续处理。
S1 discover:自动识别
扫描收件箱,识别符合目录结构的 session,计算每个源文件的 SHA256,创建批次目录并生成运行配置。本步骤只启动 Head,不启动 Worker。
- 输入:
inbox下的各 session 子目录 - 输出:
runtime.json(运行配置)、inputs.jsonl(每个 session 一行,含文件路径、大小和 SHA256)
S2 prepare:视频整理与 IMU 提取
每个 session 一行。将原始视频复制到 session 目录并逐个校验 SHA256,按相机序列号和拍摄时间整理视频目录,再从 MP4 内嵌的 GPMF 轨道中提取加速度计和陀螺仪数据。
- 输入:
inputs.jsonl - 输出:
demos/<视频目录>/raw_video.mp4、imu_data.json
S3 slam:建图与定位
先用建图视频为每个 session 建立 ORB-SLAM3 地图(单目 + 惯导),再展开为每个视频一行,基于同一张地图逐个视频定位。地图丢帧比例超过 20% 时自动重建,最多运行 2 次。夹爪标定视频不做定位。
- 输入:S2 整理后的视频和 IMU 数据
- 输出:
demos/mapping/map_atlas.osa(地图)、demos/*/camera_trajectory.csv(每段视频的相机轨迹)
说明:本步骤成功表示程序生成了轨迹。轨迹精度是否满足应用要求,需要结合跟踪状态、标定结果和独立参考另行评估。
S4 geometry:标记检测、标定与数据集规划
展开为每个视频一行,逐帧检测夹爪手指标记和桌面标记。随后按 session 汇总,计算 SLAM 坐标系到桌面标记坐标系的变换,用夹爪标定视频确定开口范围,最后生成数据集规划:按恒定帧率对齐图像、轨迹和标记,在丢跟踪处切分 episode。
- 输入:S3 的相机轨迹、镜像内置标定文件
- 输出:
demos/*/tag_detection.pkl、demos/mapping/tx_slam_tag.json、gripper_range.json、dataset_plan.pkl
TCP 位姿以桌面标记坐标系为参考,平移单位为米,旋转为轴角(弧度)。接入目标机器人前,需另行完成坐标适配和动作验证。
S5 dataset:Zarr 数据集生成
每个 session 一行。按规划逐帧解码,修补标记区域、遮挡夹爪本体,缩放到 224×224 后写入 dataset.zarr.zip,再对照规划校验帧对齐和数值有效性。图像保留鱼眼视角,未做去畸变。
- 输入:
dataset_plan.pkl、原始视频 - 输出:
dataset.zarr.zip、quality-report.json(本步骤的阶段报告)
S6 semantic:语义候选生成
按规划展开为每个 episode 一行。CPU 算子剪出 episode 片段,从第一路相机抽取 20 个关键帧,附加夹爪局部放大图和宽度、位姿读数;GPU 算子调用 Qwen3-VL-32B 生成中文任务描述和子任务分段。每张卡常驻一个模型实例,模型只加载一次。结果未通过结构校验时,会把错误信息加入提示词重试 1 次。
- 输入:
dataset_plan.pkl、原始视频 - 输出:
semantic/目录,含captions.jsonl、subtasks.jsonl、审核页index.html和summary.json
子任务分段采用整数帧的左闭右开区间 [start_frame, end_frame)。恰好落在 end_frame 上的证据帧会被去掉,修改记录写入 conversion.json。
S7 verify:质量汇总与发布
每个 session 一行。将 S6 的语义状态合并进 S5 的质量报告,生成最终质量报告 verify/quality-report.json(S5 的阶段报告保持不变)。随后发布每个 session 的数据集、规划、最终质量报告和语义目录,写入 manifest.jsonl 和 summary.json,最后写入完成标记 _SUCCESS.json。
- 输入:S5 与 S6 的产物清单
- 输出:
deliveries/<batch_tag>/下的版本化交付目录
任务拓扑
1S1 discover ─▶ S2 prepare ─▶ S3 slam ─▶ S4 geometry ─┬─▶ S5 dataset ──┬─▶ S7 verify
2  Head only      CPU           CPU         CPU       └─▶ S6 semantic ─┘     CPU
3 GPU| 工作流节点 | 步骤 | 资源 | 依赖 | Ray 行粒度 |
|---|---|---|---|---|
umi-discover |
S1 | 仅 Head | 无 | 不使用 Worker |
umi-prepare |
S2 | CPU | S1 | 每 session 一行 |
umi-slam |
S3 | CPU | S2 | 每视频一行 |
umi-geometry |
S4 | CPU | S3 | 每视频一行,再汇总 |
umi-dataset |
S5 | CPU | S4 | 每 session 一行 |
umi-semantic |
S6 | GPU | S4 | 每 episode 一行 |
umi-verify |
S7 | CPU | S5、S6 | 每 session 一行 |
每个节点运行一个 RayJob,节点结束后集群即释放。S2~S5、S7 共用同一个 CPU 任务模板,通过 stage 参数区分步骤。
输出说明
交付目录
1/mnt/data/umi/deployments/umi-<batch_tag>/deliveries/<batch_tag>/
2├── verify/_SUCCESS.json                    # 完成标记,指向本次发布的版本
3└── verify-attempts/<attempt_id>/
4    ├── manifest.jsonl                      # 交付清单,每个文件的路径、大小、SHA256
5    ├── summary.json                        # 批次汇总
6    ├── <session_id>.zarr.zip               # 数据集
7    ├── <session_id>.dataset_plan.pkl       # 数据集规划,含时间戳
8    ├── <session_id>.quality-report.json    # 最终质量报告
9    └── <session_id>.semantic/              # 语义候选与审核页
读取交付物时,请先打开 verify/_SUCCESS.json,按其中指向的 attempt_id 读取 manifest.jsonl,再按清单取文件,避免混用不同次运行的产物。
数据集 dataset.zarr.zip
Zarr v2 格式的 ZIP 存储,结构与 UMI 官方 Diffusion Policy 训练代码的 ReplayBuffer 一致,可用 zarr.ZipStore 直接打开。所有 episode 首尾相接存为一组数组,用 meta/episode_ends 切分。
| 字段 | 形状 | 类型 | 含义 |
|---|---|---|---|
meta/episode_ends |
[E] |
int64 | 每个 episode 的结束位置(不含) |
data/camera0_rgb |
[N,224,224,3] |
uint8 | 处理后的 RGB 图像 |
data/robot0_eef_pos |
[N,3] |
float32 | TCP 位置(米) |
data/robot0_eef_rot_axis_angle |
[N,3] |
float32 | TCP 姿态,轴角(弧度) |
data/robot0_gripper_width |
[N,1] |
float32 | 夹爪开口宽度(米) |
data/robot0_demo_start_pose |
[N,6] |
float64 | 所属 episode 起始位姿 |
data/robot0_demo_end_pose |
[N,6] |
float64 | 所属 episode 结束位姿 |
N为总帧数,E为 episode 数。以单相机、单夹爪的示例为例,一个 session 含 5 个 episode、2317 帧,episode_ends为[468, 932, 1303, 1712, 2317]。多相机或多夹爪时,会出现camera1_rgb、robot1_*等字段。camera0_rgb使用 JPEG XL 有损压缩(imagecodecs_jpegxl,level=99),读取环境需安装imagecodecs。- 字段名中的
robot0沿用 UMI 命名,表示第 1 个夹爪,不代表目标机器人可直接执行的动作。
注意:时间戳不存储在 Zarr 中,而是存储在同版本的
dataset_plan.pkl的episode_timestamps中。使用数据集时请一并保留该文件。
语义候选 semantic/
| 文件 | 内容 |
|---|---|
captions.jsonl |
每个 episode 一行,整段任务描述 |
subtasks.jsonl |
每个 episode 一行,子任务分段列表 |
index.html |
人工审核页,视频与候选结果对照 |
summary.json |
生成状态与审核状态 |
subtasks.jsonl 中的子任务示例:
{"start_frame": 0, "end_frame": 104, "description": "机械臂从初始位置向桌子上的蓝色杯子移动,夹爪保持张开状态,TCP位置逐渐靠近杯子。", "evidence_frames": [0, 26, 52, 78]}
所有候选的初始状态为 review_status=pending、semantic_accepted=false、training_label=false。结构校验通过只表示 JSON 格式和字段正确,不代表描述与视频相符。模型可能出现描述偏差,例如把手持夹爪称为“机械臂”,或在缺少接触证据时仍判断抓取成功。请在 index.html 中对照视频核对操作对象、接触、动作结果和分段边界,审核通过后再作为训练标签使用。
质量报告 quality-report.json
| 字段 | 含义 | 示例结果 |
|---|---|---|
status |
总体状态:PASS / WARN / FAIL | WARN |
structural |
数据集与规划一致、数值有效、边界正确 | PASS |
rgb_source_correspondence |
逐帧图像与原视频对应帧比对 | PASS |
semantic |
语义候选状态 | WARN(待审核) |
physical |
物理指标判定 | unknown |
calibration |
标定残差 | unknown |
status=WARN 是当前版本的正常结果:结构与对齐检查全部通过,但物理指标(最大速度、角速度、开口范围等)只计算、不设阈值,标定没有独立真值,语义候选也待审核。summary.json 中的 delivery_pass=true 表示交付物完整、哈希一致,不等同于 quality_pass=true。
说明:请以
verify/quality-report.json(交付目录中的<session_id>.quality-report.json)为准。S5 阶段报告中的语义状态在 S7 合并前尚未更新。
快速开始
- 将采集好的 session 目录上传到 PFS,确保挂载后路径为
/mnt/data/<收件箱路径>/<session_id>/raw_videos/,并将模型权重放到/mnt/data/umi/cache/semantic-models。 - 在百舸控制台进入 工作流 > 工作流模板,在 UMI 人类演示数据处理管线卡片上单击 创建工作流,填写名称并选择资源池。
- 在编辑器中填写必填参数:
image、queue_id、gpu_queue_id、pfs_id、gpu_resource_name、inbox和新的batch_tag。可单击 查看队列信息 核对空闲资源。 - 保存并运行工作流。在运行详情的任务页中查看各节点状态和日志,首先在 discover 节点日志中核对识别出的 session 数量。
- 全部节点成功后,按“输出说明”读取交付目录,并在
index.html中审核语义候选。
首次接入时,建议先在收件箱中只放 1 个 session 跑通全流程,确认节点日志和交付目录后再扩大数据量。示例中 3 个 session(每个含 1 段建图视频、1 段标定视频和 5 段演示视频)从创建运行到全部完成约 27 分钟,其中 S3 slam 约 7 分钟,S6 semantic 约 10 分钟。
失败处理
某个节点失败时,可在节点日志中查看出错的 session 或视频。每个步骤的逐行处理结果写在 runs/<batch_tag>/<步骤>/<attempt_id>/rows.jsonl,可据此定位失败行。
〔待确认:研发说明使用相同 batch_tag 重新运行时,会复用已完成且校验通过的产物,只重做失败部分;输入、镜像或配置发生变化时会拒绝运行。该机制尚未经过失败恢复测试,确认后补充操作步骤。〕
使用限制
- 采集设备:仅验证了 GoPro HERO9、2.7K Max Lens 模式、单相机单夹爪的数据。多相机、双手和其他相机型号需要另行验证。
- 语义结果:只从第一路相机抽帧,结果为候选,需人工审核。
- 物理精度:轨迹与标定没有独立真值,质量报告中的物理指标仅供参考,不作为通过或失败的依据。
- GPU 型号:仅验证了 RTX 4090(24 GB)。更换卡型时,请确认单卡显存可容纳 4 bit 量化的 Qwen3-VL-32B。
修改 YAML 的注意事项
如需在 YAML 模式下修改模板,请保留以下写法:
- 节点的启动命令写在
spec.command中,Head和Worker下的command保持为空。 - 不要在
envs中设置RAY_ADDRESS,该变量由平台注入。 advancedSettings.SubmitterBackoffLimit填写不带引号的数字0。- 不要设置
UMI_OVERLAY,否则会用外部代码覆盖镜像内的代码。
评价此篇文章