

在线服务部署
概述
本文档介绍如何在百舸 AI 计算平台通过控制台部署和管理在线服务。百舸平台提供灵活的部署方式,您可以将通过 Docker 构建的镜像部署为推理服务,并将模型文件或代码挂载到服务实例中。
准备工作
- 登录百舸AI计算平台,在AI计算资源池中创建全托管资源池或自运维资源池,准备算力资源;
- 准备部署在线服务所需的信息:
- 服务镜像地址,例如:
registry-vpc.cn-shanghai.aliyuncs.com/xxx/yyy:zzz。 - 镜像的启动运行命令,例如:
/data/eas/ENV/bin/python /data/eas/app.py。 - 镜像中进程监听的网络端口号,例如:
8000。
标准服务
部署服务
- 进入在线服务部署列表
登录百舸 AI 计算平台后,选择 大规模训练与推理->在线服务部署,进入在线服务部署列表页。列表页默认展示 标准服务,可查看服务名称、服务状态、资源规格、资源池、队列、创建时间等信息。
- 打开部署服务页面
在 在线服务 页签的 标准服务 列表中,单击 【部署服务】 进入标准服务创建页面。
- 填写部署服务参数
在创建页面按业务需要配置基础信息、资源配置、环境配置、流量接入和高级配置。
- 提交部署
确认所有参数后,单击 【确定】 发起部署。
基础信息
| 参数 | 说明 |
|---|---|
| 服务名称 | 支持小写字母、数字和 -,必须以小写字母开头、以小写字母或数字结尾,长度为 1-50;服务名称不可重复,创建后不支持修改。 |
| 模型配置 | 可选择 自定义模型 或 公共模型。平台支持部署自定义模型,需使用自定义镜像或平台提供的预置镜像,并自行上传模型权重;也支持主流开源模型权重,无需自行下载模型权重,支持 vLLM、SGLang、自研 AIAK 加速推理引擎,并针对不同模型提供单机、分布式、PD 分离多种部署模板,提升部署效率。 |
| 服务类型 | 选择 标准服务。 |
资源配置
| 参数 | 说明 |
|---|---|
| 资源池类型 | 选择在线服务需要部署到的资源池。自运维资源池 需要先创建资源池并购买用于 AI 推理的计算资源;全托管资源池 为免运维资源池,您无需运维和管理资源池及算力资源,由平台保障资源池稳定性。 |
| 资源队列 | 选择服务使用的资源队列。 |
| 资源规格 | 选择部署服务所需的加速芯片类型和卡数、CPU、内存;加速芯片类型选择 不使用加速芯片 时部署 CPU 服务。 |
| 分布式推理 | 模型参数量较大且无法单台机器推理时,可以开启分布式推理,将单实例部署在多台机器。 |
| 单实例 Pod 数 | 每个副本中的 Pod 数量,默认值为 2,可按需修改。 |
| RDMA | 分布式推理或 PD 分离部署时,建议开启 RDMA 优化跨节点之间的数据传输。算力资源需支持 RDMA,否则可能会调度失败。 |
| 实例数 | 设置服务实例数量。 |
| 优先级 | 支持设置在线服务优先级。资源池开启抢占功能时,平台会根据任务抢占模式进行调度,高优先级任务可抢占低优先级任务的资源。 |
环境配置
| 参数 | 说明 |
|---|---|
| 镜像地址 | 支持选择百舸预置镜像,或从百度云 CCR 镜像仓库、自建镜像仓库拉取镜像;如需私有镜像仓库授权,请输入账号密码。 |
| 启动命令 | 填写镜像的启动运行命令。 |
| 环境变量 | 将被注入到容器实例中。变量名仅支持大小写字母、数字、下划线,且不能以数字作为开头。 |
| 共享内存 | 设置容器共享内存大小。 |
| 存储挂载 | 设置模型权重文件存储的源路径和容器挂载的目标路径。 |
| 健康检查 | 可通过健康检查自动检测并恢复异常状态的容器,确保只有健康实例接收流量。支持存活探针、就绪探针、启动探针;检查方法包括 HTTP 请求检查、TCP 连接检查和自定义执行命令。 |
流量接入
| 参数 | 说明 |
|---|---|
| 负载均衡类型 | 支持 AI 原生网关(7 层)和传输层负载均衡(4 层)两种接入方式。AI 原生网关和传输层负载均衡的调用方式不同,详见 API调用示例。 |
| AI 原生网关 | 为服务提供鉴权机制,提供应用层监控指标采集、消费者鉴权、限流等功能。可单击 【创建 AI 原生网关】 创建网关实例,参考 创建网关实例。使用网关部署服务支持设置负载均衡策略,服务部署成功后可在服务监控中查看流量监控。 |
| 传输层负载均衡 | 提供更底层的流量转发能力,无应用层解析开销,转发效率更高。使用该方式接入流量时,需要选择 BLB 负载均衡实例;如需通过公网调用服务,请选择支持公网的 BLB 实例。仅支持绑定应用型实例,多个服务可以绑定同一个 BLB 实例。 |
| 端口 | 使用 AI 原生网关时,填写容器内监听端口,外部调用端口默认为容器内监听端口;使用传输层负载均衡时,复用同一 BLB 实例的服务外部请求调用端口不能重复,可以使用自动分配端口功能生成端口。 |
注意: 使用旧版本网关部署的服务会影响后续新功能的使用,请联系技术支持人员升级至新版本,升级不会变更服务调用地址、鉴权信息。
高级配置
| 参数 | 说明 |
|---|---|
| 服务告警 | 支持对长时间未部署成功的实例进行监控告警,开启后可以设置告警和通知策略。 |
| 网关认证鉴权 | 仅支持使用 AI 原生网关部署的服务开启网关认证鉴权,关闭后将不提供鉴权功能。 |
| 最小实例数 | AI Job 调度器开启任务抢占模式时,可设置当前服务至少保留不被抢占的最小副本数。 |
| 优雅退出时间 | 实例退出前将等待一段时间处理已经接收的请求,以减少实例变更带来的请求报错;无特殊需求建议使用默认值 30s。 |
| 碎片迁移 | 开启后,资源池治理碎片资源时此服务将不再接收新请求,并在优雅退出时间后自动删除实例并重建;关闭后,碎片整理时将不会迁移此服务。 |
| 滚动更新 | 支持为服务设置滚动更新策略,需要输入最大不可用和最大超量实例数比例。最大不可用表示滚动更新过程中不可用实例数量占预期实例数的百分比,范围 1%-100%;最大超量表示滚动更新过程中超出预期的实例数量占预期实例数的百分比,范围 1%-100%。 |
升级服务
- 进入标准服务列表
登录百舸 AI 计算平台后,选择 大规模训练与推理->在线服务部署,在 在线服务 页签下选择 标准服务。确认目标服务已部署成功,并处于可操作状态。
- 打开升级服务页面
在目标标准服务所在行的 操作 列中,单击 【升级服务】 进入服务配置编辑页面。可按需修改镜像版本、存储挂载、健康检查、滚动更新策略等配置。
- 提交升级
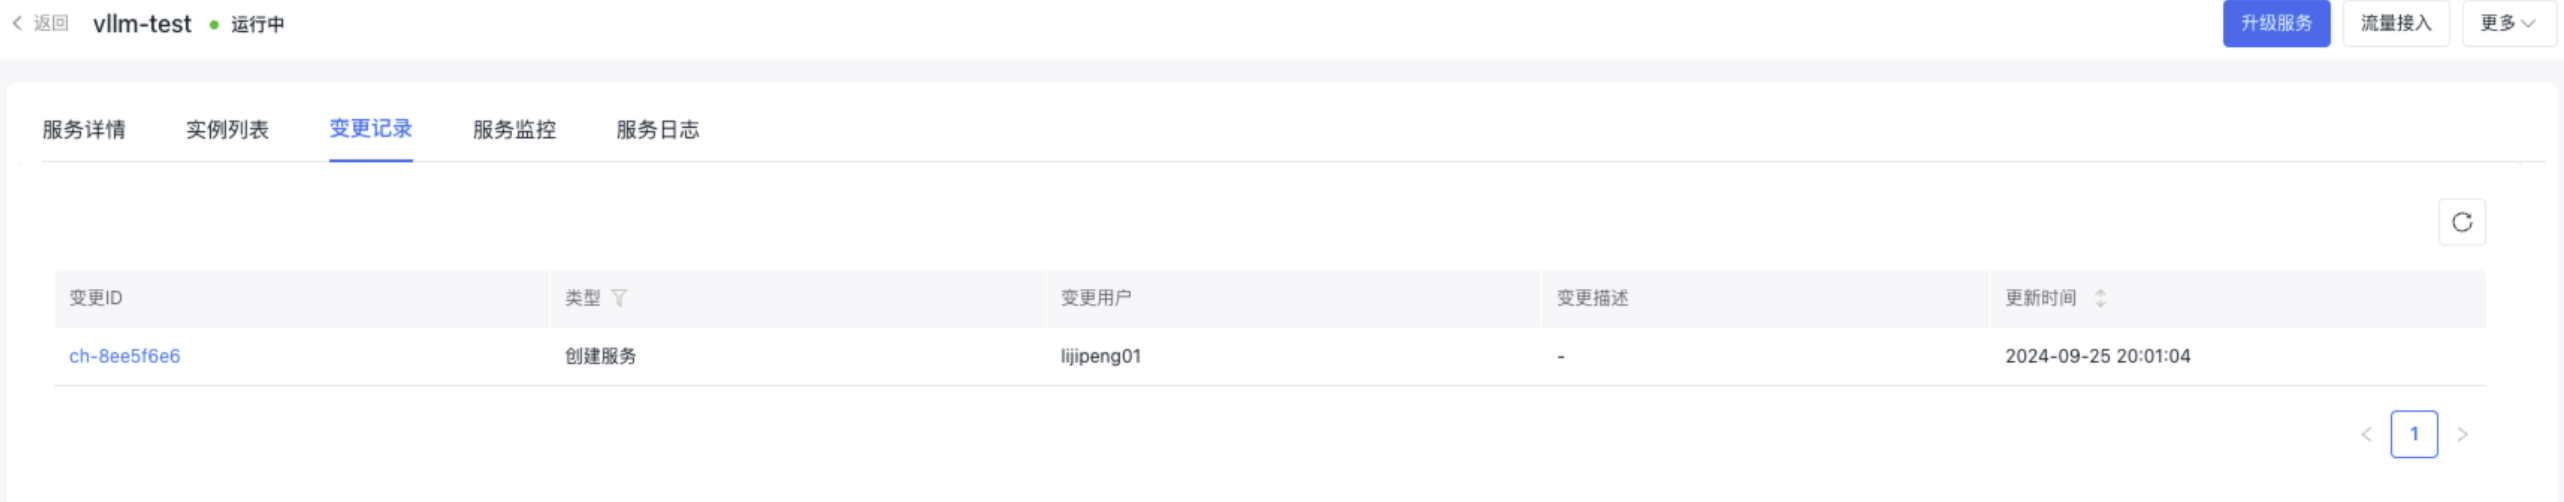
完成配置修改后,在变更描述中填写本次升级内容,单击 【确定】 提交升级。提交后返回服务列表,等待服务状态恢复为运行中。
- 查看版本变更记录
升级完成后,进入服务详情页,查看服务的版本变更记录,确认本次升级记录已生成。
手动扩缩容
- 进入标准服务列表
登录百舸 AI 计算平台后,选择 大规模训练与推理->在线服务部署,在 在线服务 页签下选择 标准服务。
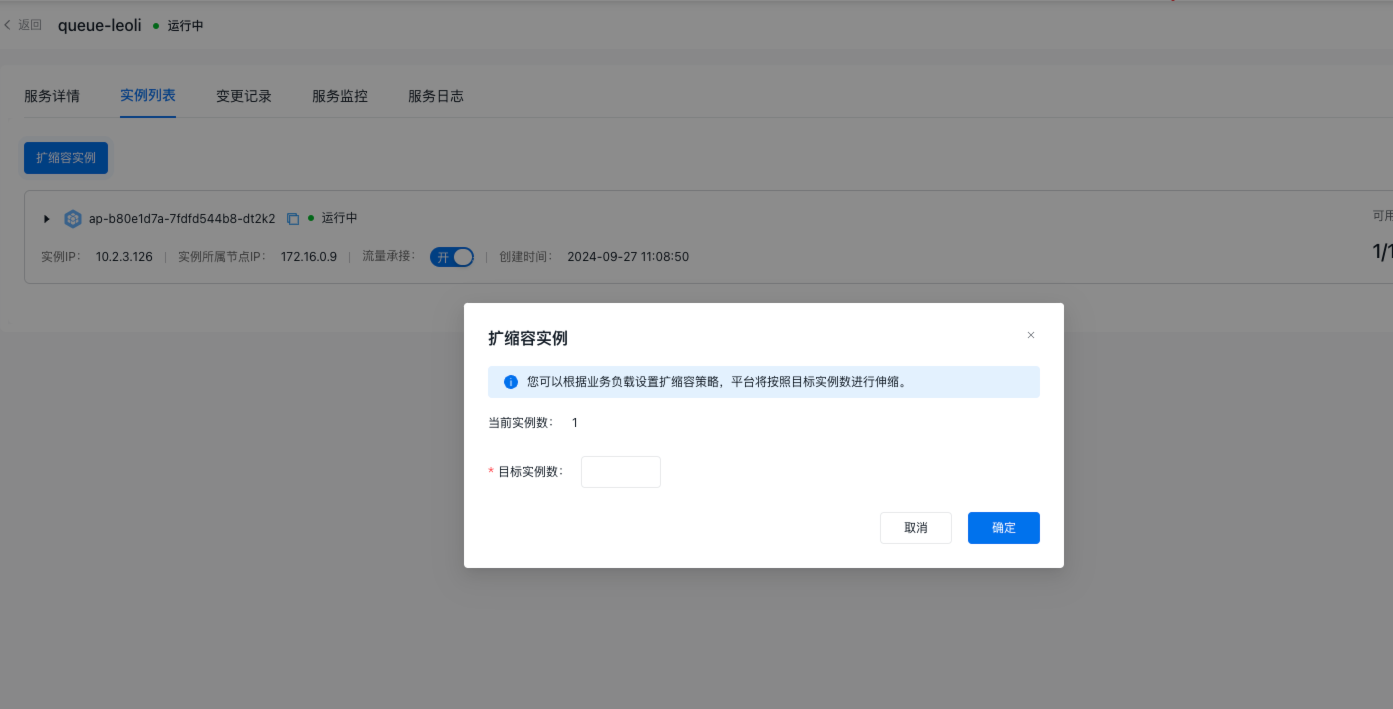
- 调整服务实例数
服务部署成功后,如果服务流量发生变化,可对目标服务执行手动扩缩容,调整实例数以满足流量负载要求。
- 确认扩缩容结果
提交扩缩容后,返回服务列表或服务详情页,确认服务状态、实例数量和实例运行状态符合预期。
实例摘流
当某个实例出现故障或性能问题,为了避免服务中断,可以通过实例摘流来平滑过渡。开启实例摘流后,需要等待几分钟生效。
流量接入
服务部署成功后,您可以在服务列表查看调用信息。在服务详情中修改流量接入的负载均衡实例,负载均衡类型不支持变更。
删除保护
服务部署成功后,支持开启删除保护,防止在线服务被误操作删除。
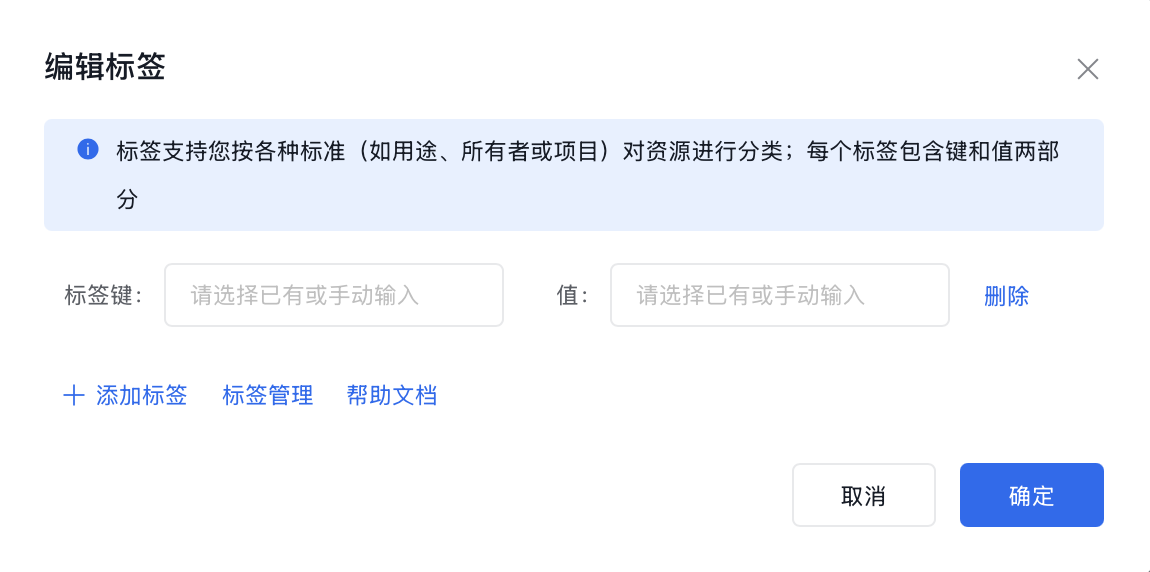
设置标签
服务部署成功后,支持为服务设置标签,用于服务筛选和统计。
多角色服务组
用于实现 PD 分离或更多角色服务的关联,负责部署多角色之间有复杂调度逻辑且需要统一流量入口的服务。
- PD 分离必须从多角色服务组入口部署。
- 本期多角色服务组仅支持部署 Prefill 和 Decode 两个角色的服务。
- 多角色服务组仅支持使用 AI 原生网关接入流量。
- 服务组中的服务不能单独调用。
部署多角色服务组
- 登录百舸AI计算平台,点击左侧导航栏中的 在线服务部署 服务进入列表页面。
- 选择 多角色服务组,单击 部署多角色服务组 进入创建页面。
- 在创建页面填写相关参数,具体参数如下:
基础信息
| 参数 | 说明 |
|---|---|
| 服务名称 | 支持小写字母、数字和 -,必须以小写字母开头、以小写字母或数字结尾,长度为 1-50;服务名称不可重复。 |
| 模型配置 | 选择需要部署的模型配置。 |
| 服务类型 | 选择 多角色服务。多角色服务仅支持使用 SGLang 推理引擎部署。 |
服务配置
| 参数 | 说明 |
|---|---|
| 资源池类型 | 选择在线服务需要部署到的资源池,仅支持全托管资源池。全托管资源池为免运维资源池,您无需运维和管理资源池及算力资源,由平台保障资源池稳定性。 |
| 服务角色 | 仅支持 Prefill 和 Decode 两种角色,且固定角色名不能修改。 |
| 资源队列 | 同一服务组中的多角色服务不能跨资源池,可以跨资源队列。 |
| 资源规格 | 选择部署服务所需的加速芯片类型和卡数、CPU、内存;加速芯片类型选择 不使用加速芯片 时部署 CPU 服务。 |
| 实例数 | 分别设置 Prefill 和 Decode 角色的实例数量。 |
| 分布式推理 | 根据模型规模和部署方式决定是否开启。 |
| 单实例 Pod 数 | 性能最优推荐 Prefill 和 Decode 服务单实例 Pod 数为 4,即分别部署到 4 台机器。 |
| RDMA | 分布式推理或 PD 分离部署时,建议开启 RDMA 优化跨节点之间的数据传输。算力资源需支持 RDMA,否则可能会调度失败。 |
| KV Cache 感知调度 | 开启后平台会感知 Prefill 节点的缓存命中率,将请求调度到命中率高的实例,提升计算效率并降低首 Token 延迟。 |
| 镜像地址 | 支持选择百舸预置镜像,或从百度云 CCR 镜像仓库、自建镜像仓库拉取镜像;如需私有镜像仓库授权,请输入账号密码。 |
| 端口 | 支持自定义监听和调用端口,开启公网访问后会自动暴露此端口。如需根据业务逻辑设置自定义监控指标,对应的监控端口用途请选择 Metrics。8001、8002 端口已被系统占用,为避免服务因端口冲突而无法正常完成启动,请勿设置为 8001、8002。 |
| 启动命令 | 填写镜像的启动运行命令。 |
| 环境变量 | 将被注入到容器实例中。变量名仅支持大小写字母、数字、下划线,且不能以数字作为开头。 |
| 共享内存 | 设置共享内存大小。 |
| 存储挂载 | 设置模型权重文件存储的源路径和容器挂载的目标路径。 |
| 健康检查 | 可通过健康检查自动检测并恢复异常状态的容器,确保只有健康实例接收流量。支持存活探针、就绪探针、启动探针;检查方法包括 HTTP 请求检查、TCP 连接检查和自定义执行命令。 |
| 优先级 | 支持设置在线服务优先级。资源池开启抢占功能时,平台会根据任务抢占模式进行调度,高优先级任务可抢占低优先级任务的资源。 |
| 最小实例数 | AI Job 调度器开启任务抢占模式时,可设置当前服务至少保留不被抢占的最小副本数。 |
| 优雅退出时间 | 实例退出前将等待一段时间处理已经接收的请求,以减少实例变更带来的请求报错;无特殊需求建议使用默认值 30s。 |
| 碎片迁移 | 开启后,资源池治理碎片资源时此服务将不再接收新请求,并在优雅退出时间后自动删除实例并重建;关闭后,碎片整理时将不会迁移此服务。 |
| 滚动更新 | 支持为服务设置滚动更新策略,需要输入最大不可用和最大超量实例数比例。最大不可用表示滚动更新过程中不可用实例数量占预期实例数的百分比,范围 1%-100%;最大超量表示滚动更新过程中超出预期的实例数量占预期实例数的百分比,范围 1%-100%。 |
- 配置流量接入
在页面下方的 流量接入 区域选择 AI 原生网关。如当前没有可用网关,可单击 【创建 AI 原生网关】,参考 创建网关实例 创建网关实例;创建的网关需与服务所属资源池在同一 VPC,且仅支持绑定运行中状态的网关实例。
选择网关后,可配置 负载均衡策略,控制台提供 轮询、最小连接数、随机 三种策略。确认 Prefill 和 Decode 两个角色配置、网关及高级配置无误后,单击 【确定】 提交部署。
| 参数 | 说明 |
|---|---|
| AI 原生网关 | 多角色服务组仅支持使用 AI 原生网关接入流量。使用网关部署服务支持设置负载均衡策略,服务部署成功后可在服务监控中查看流量监控。 |
| 负载均衡策略 | 支持 轮询、最小连接数、随机。 |
| 网关认证鉴权 | 仅支持使用 AI 原生网关部署的服务开启网关认证鉴权,关闭后将不提供鉴权功能。 |
注意: 使用旧版本网关部署的服务会影响后续新功能的使用,请联系技术支持人员升级至新版本,升级不会变更服务调用地址、鉴权信息。
调用信息
多角色服务组的统一入口调用地址。
流量接入
服务部署成功后,您可以在服务列表查看调用信息。在服务详情中修改流量接入的负载均衡实例,负载均衡类型不支持变更。
删除
删除服务组和服务组中的服务。
评价此篇文章