

FlashCkpt:大模型训练高性能ckpt保存
FlashCkpt 是百舸 AI 计算平台为 PyTorch 大模型训练场景而开发的高性能 Checkpoint 框架,实现接近 0 开销的模型状态保存。本文介绍如何使用百舸 FlashCkpt 的能力,提升 Checkpoint 保存性能。
背景信息
大模型训练随着参数量和数据规模的增长,受限于单机 GPU 内存容量限制,通常会使用分布式训练框架进行训练。但是分布式训练中可能会遇到单点节点故障、系统问题等难以预知的异常问题,造成训练任务中断。
在实际训练过程中,通常会开启定期 Checkpoint 机制来保存和恢复进度,尽量降低训练中断带来的算力浪费,但 Checkpoint 本身的耗时与模型大小成正比。对于百亿、千亿参数的大模型,单次 Checkpoint 的保存时间开销通常在几分钟到十几分钟之间。Checkpoint 间隔时间较短会使训练任务频繁暂停,GPU 算力严重浪费;Checkpoint 间隔时间较长,一旦发生中断,之前损失的迭代次数在恢复时需要重新计算。以 1 千卡为例,假设每 4 小时 Checkpoint 一次,单次保存耗时 10 分钟,那么每天因 Checkpoint 损失的 GPU 算力接近 1000 卡时。
因此,在大规模分布式训练时,需要一种低成本、可靠的方法来保存最新的 Checkpoint,降低时间和资源浪费,提升 GPU 的有效训练时长。
方案介绍
FlashCkpt 核心思路: Checkpoint 保存与模型训练过程重叠,降低 Checkpoint 保存占用 GPU 训练的有效时间。

收益
分别针对 7B、70B、130B 三种参数规模的模型训练进行对比测试,百舸 FlashCkpt 相比于原生 Ckpt 方案,单次保存耗时最高减少 93% 到 99%。
| 模型参数 | ckpt 文件大小 | 训练环境配置 | 原生 ckpt 单次保存耗时(秒) | 百舸 FlashCkpt 单次保存耗时(秒) |
|---|---|---|---|---|
| 7B | 88 GB | 模型切分:1 TP 1 PP 8 DP 机器配置:NVIDIA A800-SMX4-80G,1 node,8 GPUs |
35 | 2.5 |
| 70B | 899 GB | 模型切分:2 TP 8 PP 2 DP 机器配置:NVIDIA A800-SMX4-80G,4 node,32 GPUs |
143 | 4 |
| 130B | 1702 GB | 模型切分:4 TP 6 PP 2 DP 机器配置:NVIDIA A800-SMX4-80G,6 node,48 GPUs |
262 | 3.8 |
说明:
- 训练镜像:
registry.baidubce.com/cce-ai-native/aiak-megatron:ubuntu20.04-cu11.8-torch1.14.0-py38_v1.2.3.0_release- 以上相同参数的模型,在 ckpt 保存耗时的对比测试中,采用相同的共享存储,排除存储性能的影响。
使用说明
使用限制
- 内存占用:单机所有 GPU 卡的 Checkpoint 会优先保存在内存中,因此对于千亿参数规模模型,单机建议预留 200 GB 以上内存。
- 框架支持:当前仅支持 Megatron 训练框架(<= 23.04 版本),DeepSpeed 支持中。
使用方式
提供以下两种使用方式:
- 通过 AIAK 加速镜像使用:适用于在训练中直接使用 AIAK-Training 加速镜像的用户。
- 通过代码包使用:适用于自定义训练镜像的用户。
通过 AIAK 镜像使用
FlashCkpt 的能力已经默认集成到 AIAK-Training 加速镜像 v1.2.3.0 及更高版本中,通过在启动命令中增加 --enable-accelerate-checkpoint 一键开启 FlashCkpt 加速。
- AIAK-Training 加速镜像 v1.2.3.0 版本:
1registry.baidubce.com/cce-ai-native/aiak-megatron:ubuntu20.04-cu11.8-torch1.14.0-py38_v1.2.3.0_release  # NVIDIA A800 机型适用
2registry.baidubce.com/cce-ai-native/aiak-megatron:ubuntu22.04-cu12.2-torch2.1.0-py310_v1.2.3.0_release # NVIDIA H800 机型适用- 启动命令示例:
1OTHER_ARGS="--data-path $DATA_PATH \
2            --data-impl mmap \
3            --split 949,50,1 \
4            --save $CHECKPOINT_SAVE_PATH \
5            --load $CHECKPOINT_LOAD_PATH \
6            --enable-accelerate-checkpoint \
7            --tensorboard-dir ${TENSORBOARD_PATH} \
8            --distributed-backend nccl"
通过代码包使用
- 下载加速包。
按容器 base 镜像选择对应加速包下载:
1wget https://cce-ai-aihc.bj.bcebos.com/Checkpoint/AIDK_CentOS7-0.1.0-py3-none-any.whl
2wget https://cce-ai-aihc.bj.bcebos.com/Checkpoint/AIDK_Ubuntu20-0.1.0-py3-none-any.whl- 安装加速包。
以下以 AIDK_Ubuntu20-0.1.0-py3-none-any.whl 为例:
1pip3 install AIDK_Ubuntu20-0.1.0-py3-none-any.whl- 导入加速包,只需要修改 2 行代码。
- 替换 Megatron 的 Checkpoint 接口。
- 在最后一次 Checkpoint 结束后,调用
finish_checkpoint_process()通知 Checkpoint,确保最后一次 Checkpoint 正常结束。
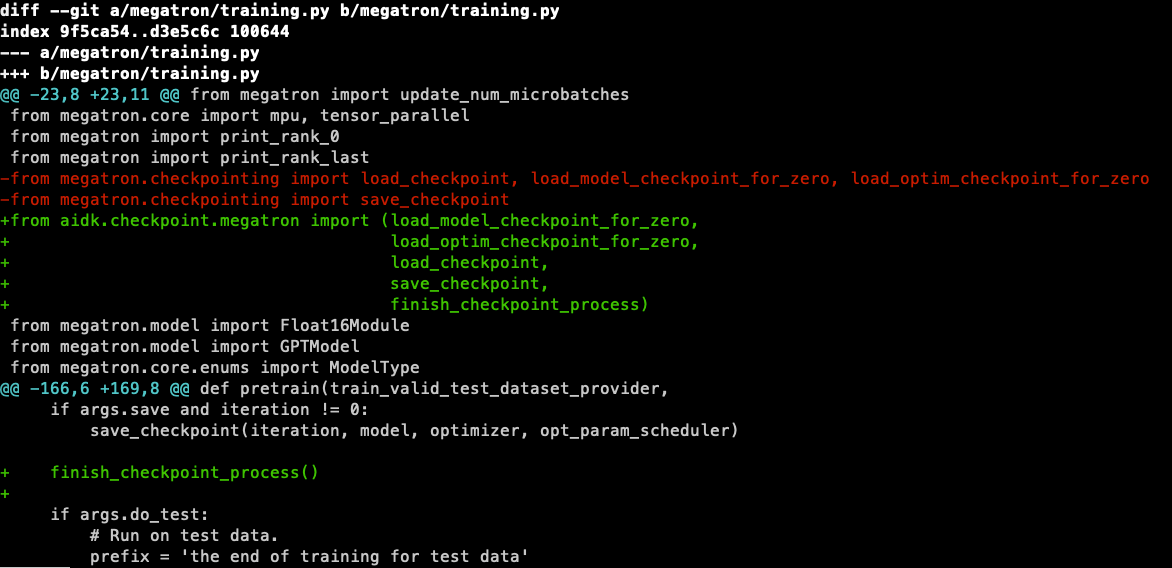
需要替换的导入代码如下:
1from aidk.checkpoint.megatron.checkpointing import (
2    load_model_checkpoint_for_zero,
3    load_optim_checkpoint_for_zero,
4    load_checkpoint,
5    save_checkpoint,
6    finish_checkpoint_process,
7)
在最后一次 Checkpoint 结束后调用:
1finish_checkpoint_process()观察效果
任务启动后,可以通过查询 rank0 的日志获取 ckpt 信息。
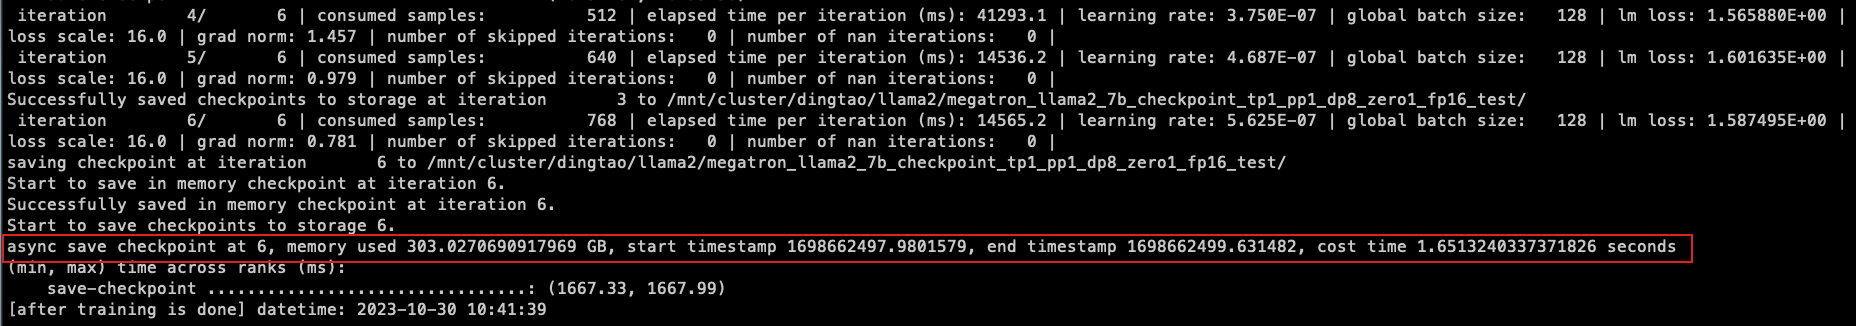
| 字段 | 解释 |
|---|---|
async save checkpoint at 6 |
当前 Checkpoint 采用异步 Checkpoint,保存的是 iteration 6。 |
memory used |
当前内存使用情况(系统整体内存使用情况,仅供参考)。 |
start timestamp |
本次 Checkpoint 的开始时间戳。 |
end timestamp |
本次 Checkpoint 的结束时间戳(不包括 Checkpoint 保存到存储的时间)。 |
cost time |
本次 Checkpoint 接口调用的总耗时(不包括 Checkpoint 保存到存储的时间)。 |
评价此篇文章