

快速提交MPI任务
概述
本文档介绍在百舸平台中使用 MPI(Message Passing Interface) 类型工作负载运行分布式训练任务的基本原理、启动命令配置方法、控制台配置流程以及常见问题处理方式。
MPI 是一种成熟、稳定的进程通信模型,广泛应用于高性能计算(HPC)与深度学习分布式训练。百舸平台提供的 MPI 类型工作负载,使用户可以在 Kubernetes 环境中以原生方式运行 MPI 训练任务,适用于:
- 多节点、多 GPU 训练。
- 需要精细控制进程拓扑与通信方式的任务。
- 基于 NCCL / RDMA 的高性能通信场景。
- 框架层(PyTorch / Horovod / Megatron / DeepSpeed 等)对 MPI 兼容良好的训练任务。
MPI 训练基本原理
MPI 进程模型
MPI 采用 多进程(Multi-Process) 模型:
- 每个训练进程拥有独立的进程空间。
- 进程之间通过 MPI 通信库进行点对点或集合通信。
- 每个进程有唯一的
RANK。 - 所有进程共享
WORLD_SIZE。
常见逻辑关系如下:
| 概念 | 含义 |
|---|---|
WORLD_SIZE |
全局进程总数 |
RANK |
当前进程在全局中的编号 |
LOCAL_RANK |
当前节点内的进程编号 |
NODE_RANK |
节点编号 |
在 GPU 训练中,通常 1 个 MPI 进程绑定 1 张 GPU。
工作机制
MPI Operator 主要由以下角色组成:
-
MPI Launcher
- 负责执行
mpirun。 - 生成
hostfile。 - 拉起 Worker Pod 中的 MPI 进程。
- 负责执行
-
MPI Worker
- 实际运行训练进程。
- 提供计算资源(CPU / GPU / RDMA)。
整体流程如下:
- MPIJob 提交: 用户通过百舸平台提交 MPIJob 自定义资源,配置任务命令、Worker 数量、资源规格及镜像信息,触发任务调度流程。
- Launcher Pod 启动: 集群优先调度 Launcher Pod,作为 MPI 任务的主控入口,其成功启动是后续 Worker 调度的前提。
- hostfile 自动注入: MPI Operator 在检测到 Launcher 与 Worker Pod 就绪后,自动收集 Worker 节点信息并生成标准
hostfile,注入至 Launcher 容器。 - mpirun 启动 Worker 进程: Launcher Pod 内执行
mpirun,基于hostfile通过 SSH 或 PMI 协议在各 Worker Pod 中拉起 MPI 进程。 - MPI / NCCL 通信执行: 所有 Worker 进程启动完成后,进入业务执行阶段,通过 MPI 或 NCCL 完成参数同步与计算协同,直至任务结束。
镜像依赖与环境准备
| 参数 | 要求 |
|---|---|
| 运行用户 | root |
| MPI | 镜像中必须包含 mpirun |
| SSH | 支持 root 用户 SSH 免密登录 |
sshd |
Worker 容器中必须可启动 sshd |
| 配置文件 | /etc/ssh/sshd_config 中关闭 StrictModes |
本文测试镜像如下:
1registry.baidubce.com/cce-plugin-dev/deepspeed-training:23.08-gpu-py310-cu122-ubuntu22.04MPI 启动方式与命令结构
基本 mpirun 结构
1mpirun \
2  --hostfile /etc/mpi/hostfile \
3  -np 4 \
4  -bind-to none \
5  -map-by slot \
6  -x NCCL_DEBUG=INFO \
7  -x NCCL_IB_DISABLE=1 \
8  python /app/train.py
参数说明
OpenMPI 的 mpirun 参数较多,以下按功能分类说明核心参数。
1. 进程管理类
| 参数 | 完整写法 | 作用 | 场景使用建议 |
|---|---|---|---|
-np |
--np <num> |
指定总 MPI 进程数 | 值需匹配 Worker Pod 数 × 每个 Pod 进程数。(如 2 Worker × 2 进程 = -np 4) |
-npernode |
--npernode <num> |
每个节点启动的进程数 | 推荐使用:显式控制每个 Worker Pod 的进程数(如 -npernode 2),避免进程分配不均 |
--hostfile |
--hostfile <path> |
指定节点列表文件 | 路径固定使用 /etc/mpi/hostfile(MPI Operator 自动生成,包含所有 Worker Pod 的 IP / 端口)。 |
--host |
--host <host1:slot1,host2:slot2> |
手动指定节点 | 禁用:MPI Operator 已自动生成 hostfile,手动指定会冲突。 |
-oversubscribe |
--oversubscribe |
允许进程数超过节点 slot 数 | 谨慎使用:仅当 K8s 资源充足时临时调试,生产环境禁用(易导致资源耗尽) |
2. 通信配置类
| 参数 | 完整写法 | 作用 | 场景使用建议 |
|---|---|---|---|
-mca pml <layer> |
--mca pml <layer> |
指定进程间通信层(PML) | -mca pml ob1(OpenMPI 4.x 稳定版,适配 K8s 网络);禁用 ucx(K8s 集群中易出网络问题) |
-mca btl <layers> |
--mca btl <layers> |
指定字节传输层(BTL) | -mca btl tcp,self(K8s 集群内通信基于 TCP,self 仅兜底);禁用 openib(无 InfiniBand 时会报错) |
-mca btl_tcp_if_exclude <iface> |
- | 排除指定网卡 | 避免使用本地回环或容器网卡通信。 |
-mca btl_tcp_if_include <iface> |
- | 仅使用指定网卡 | 若集群有专用通信网卡(如 eth0),可指定 -mca btl_tcp_if_include eth0 |
-mca oob_tcp_if_exclude <iface> |
- | 排除 OOB(带外通信)网卡 | 同 btl_tcp_if_exclude ,推荐同步配置。 |
3. 资源绑定类
| 参数 | 作用 | MPI Operator 场景使用建议 |
|---|---|---|
-bind-to <type> |
绑定进程到 CPU 核心、NUMA 节点或不绑定 | 推荐使用 -bind-to none,禁用绑定,交给K8s调度;禁用core/socket,易导致资源冲突 |
-map-by <type> |
进程分配策略 | 推荐使用 -map-by slot,按 slot 均匀分配进程,适配 K8s Pod 资源模型;禁用 node/core(分配不均)。 |
--report-bindings |
打印进程绑定信息 | 调试或验证时使用,确认进程是否被错误绑定。 |
4. 环境变量传递类
Launcher Pod 的环境变量不会自动同步到 Worker,需要显式传递核心变量。
| 参数 | 作用 | 场景使用建议 |
|---|---|---|
-x <var> |
传递单个环境变量到所有 Worker | 至少传递 -x PATH(保证命令可执行)、-x LD_LIBRARY_PATH(保证依赖库找到);GPU 任务需加 -x NCCL_DEBUG=INFO(调试)、-x NCCL_SOCKET_IFNAME=eth0(指定 NCCL 通信网卡) |
-x <var>=<value> |
传递并覆盖环境变量值 | 推荐:如 -x NCCL_DEBUG=INFO、-x CUDA_VISIBLE_DEVICES=0 |
--env-file <file> |
从文件读取环境变量 | 环境变量较多时使用,文件中每行格式为 VAR=VALUE。 |
5. 调试 / 日志类
| 参数 | 作用 | 场景使用建议 |
|---|---|---|
-v / --verbose |
打印详细启动日志 | 调试时使用,排查进程启动失败问题。 |
--debug |
打印调试级日志 | 仅深度排查时使用(日志量较大)。 |
-mca orte_base_help_aggregate 0 |
禁用日志聚合,每个进程单独输出日志。 | 调试时使用,用于定位单个 Worker 的日志问题。 |
--display-map |
打印进程分配映射,展示哪个进程运行在哪个 Worker。 | 用于验证进程分配是否符合预期。 |
6. 容错 / 超时类
| 参数 | 作用 | 场景使用建议 |
|---|---|---|
-timeout <sec> |
设置任务超时时间 | -timeout 3600(1 小时),防止任务卡死后长期占用资源。 |
-mca plm_rsh_no_tree_spawn 1 |
禁用树形启动,直接启动所有进程。 | Kubernetes 集群中稳定性更高。 |
-mca orte_abort_on_non_zero_status 1 |
任意进程非 0 退出时,整个任务终止 | 生产环境保证任务原子性。 |
--leave-sessions-attached |
进程退出后保留会话,便于排查退出现场。 | 调试时使用,生产环境不建议使用。 |
7. 其他实用类
| 参数 | 作用 | 场景使用建议 |
|---|---|---|
-quiet |
静默模式,仅打印错误日志。 | 生产环境推荐使用,减少日志量。 |
--tag-output |
为每个进程输出添加标签(进程ID) | 分布式任务排障时推荐使用,便于区分不同进程日志。 |
-wdir <path> |
指定所有进程的工作目录 | 推荐使用,统一设置为业务代码目录,如 -wdir /app。 |
hostfile 说明
百舸平台会自动为 MPI 任务注入 /etc/mpi/hostfile,内容如下:
1job-xxx-worker-0.job-xxx-worker.default.svc slots=8
2job-xxx-worker-1.job-xxx-worker.default.svc slots=8
用户无需手动创建或修改 hostfile。
MPI 任务实践
本文档介绍在百舸平台中使用 DeepSpeed 进行分布式训练的最佳实践。本文以 2 个 Worker 节点、每个节点 2 张 GPU 的典型集群配置为场景,展示如何正确配置和启动训练任务。本方案中的 MPI 核心参数配置具有通用性,可适配各类 MPI 任务,使用时根据训练代码和参数进行调整即可。
训练镜像
镜像中包含 CIFAR10 数据集,路径为 /root/code/training/data。训练代码路径为 /root/code/training/cifar10_deepspeed.py,参考 https://github.com/deepspeedai/DeepSpeedExamples/blob/master/training/cifar/cifar10_deepspeed.py。
1registry.baidubce.com/cce-plugin-dev/deepspeed-training:23.08-gpu-py310-cu122-ubuntu22.04启动命令详解
1. 启动命令
1mpirun -np 4 \
2    -bind-to none -map-by slot \
3    -mca pml ob1 -mca btl ^openib \
4    -x NCCL_DEBUG=INFO \
5    python /root/code/training/cifar10_deepspeed.py \
6    --deepspeed \
7    --epochs 128 \
8    --stage 2 \
9    --dtype fp16 \
10    --log-interval 100
2. 基础 MPI 命令说明
1mpirun -np 4 \
2    --hostfile /etc/mpi/hostfile \
3    --allow-run-as-root \
4    -bind-to none -map-by slot \
5    -mca pml ob1 -mca btl ^openib \
6    python /root/code/training/cifar10_deepspeed.py
参数解析如下:
-np 4:启动 4 个进程,对应 2 个 Worker 节点 × 每个 Worker 节点 2 张 GPU。--hostfile /etc/mpi/hostfile:指定集群节点配置文件。--allow-run-as-root:在容器化环境中允许以 root 身份运行。-bind-to none -map-by slot:将进程按 slot 映射到各个 GPU。-mca pml ob1 -mca btl ^openib:使用 TCP 通信而非 InfiniBand,提高兼容性。
3. DeepSpeed 相关参数说明
1--deepspeed \
2--epochs 128 \
3--stage 2 \
4--dtype fp16 \
5--log-interval 100 \
6--micro-batch-size 2 \
7--gradient-accumulation-steps 1
参数解析如下:
--deepspeed:启用 DeepSpeed 训练引擎。--epochs:设置训练轮数。--stage:设置 ZeRO 优化阶段,Stage 2 可在保持训练速度的同时减少显存占用。--dtype:设置训练精度,使用 fp16 可减少显存使用并加速计算。--log-interval:设置日志打印间隔。--micro-batch-size:设置每个 GPU 上的批次大小。--gradient-accumulation-steps:设置梯度累积步数,用于模拟更大批次训练。
控制台配置
1. 进入分布式训练任务创建页
在百舸控制台选择 大规模训练与推理->分布式训练,进入分布式训练任务列表页,点击 【创建任务】。在创建任务页面填写基础信息。
2. 配置镜像和执行命令
在 环境信息 区域选择 【镜像地址】,填写训练镜像地址,镜像地址可以使用registry.baidubce.com/cce-plugin-dev/deepspeed-training:23.08-gpu-py310-cu122-ubuntu22.04。执行命令可使用本文“启动命令详解”中的 MPI + DeepSpeed 启动命令,并根据实际训练脚本路径、训练轮数、精度类型等参数进行调整。
3. 配置 MPI 训练资源
在 资源配置 区域选择MPI训练框架,设置worker数量和资源规格,可以配置2个节点,每个节点2张卡。
确认 Worker 实例数量与 GPU 卡数配置符合总进程数设置。例如启动命令中配置 -np 4 时,资源规格应能提供 4 张 GPU。

4. 运行任务
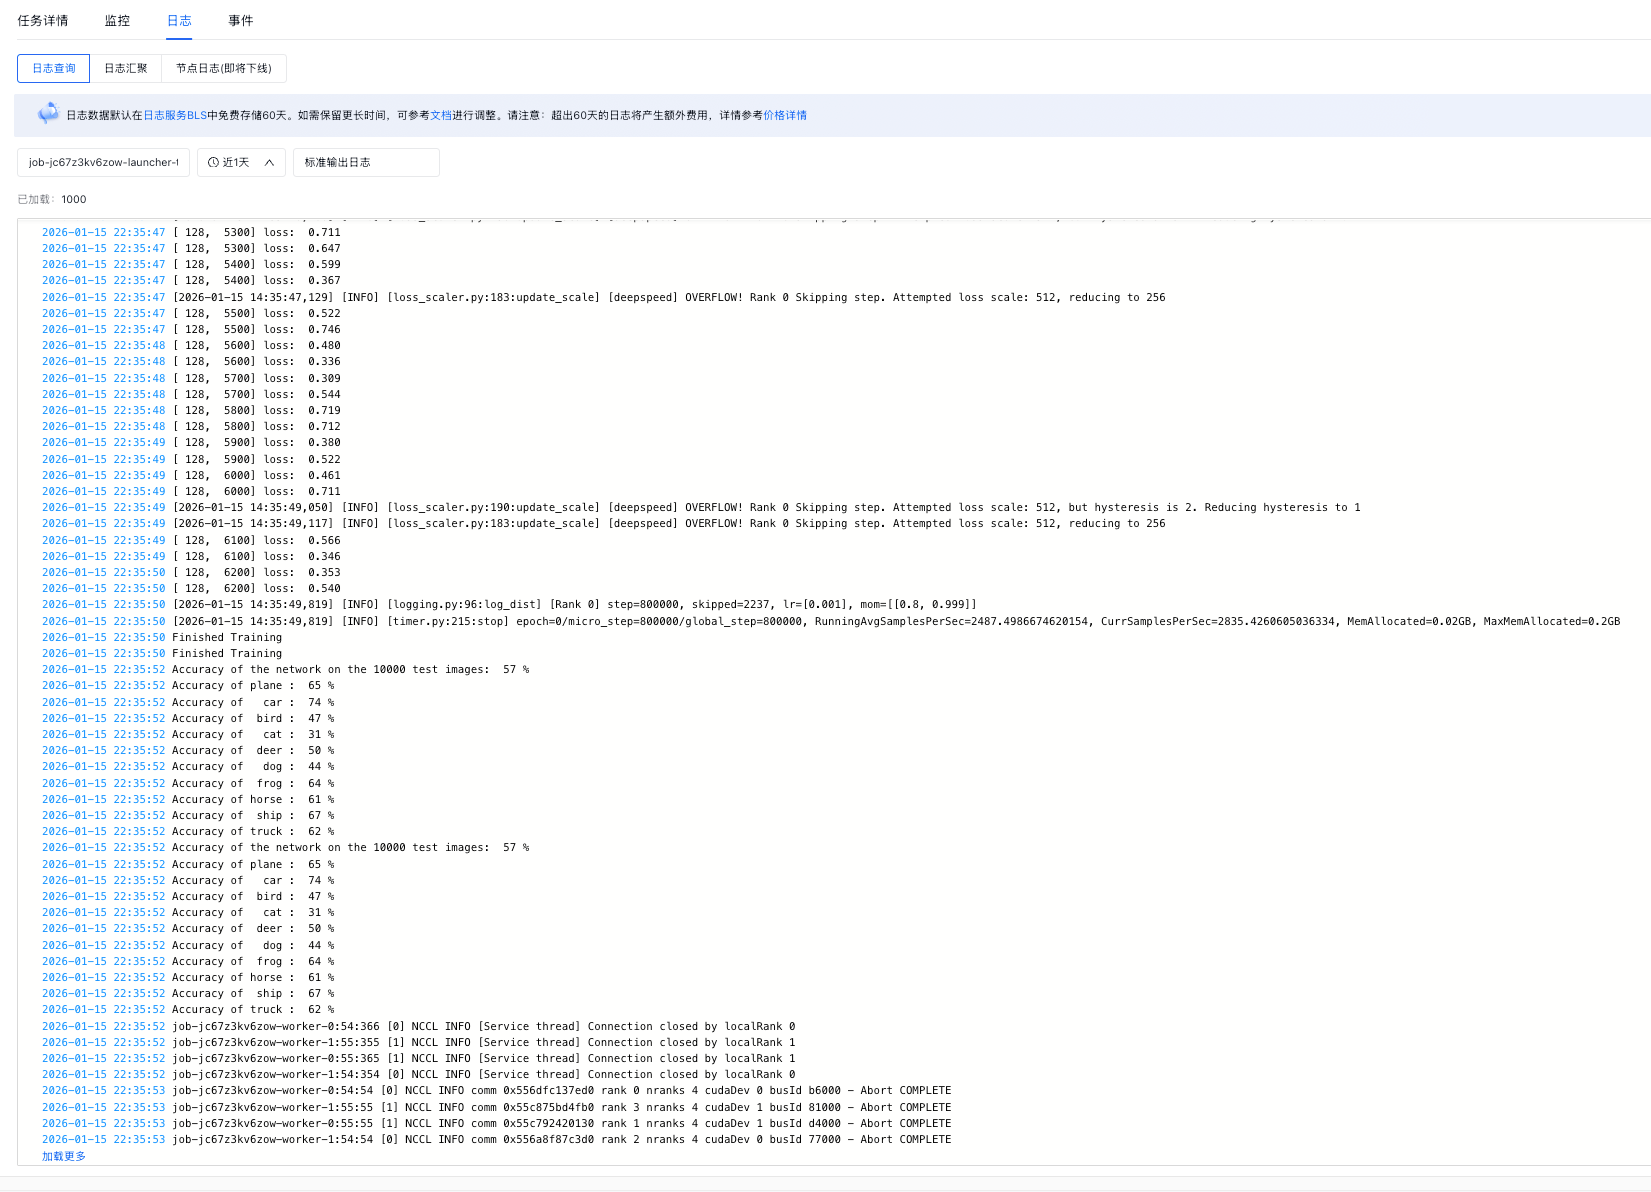
点击确定按钮提交任务开始运行。
常见问题(FAQ)
1. sshd 启动失败:Missing privilege separation directory: /run/sshd
原因: 容器中 /run/sshd 不存在。
解决方案: 构建镜像时添加如下命令。
1mkdir -p /run/sshd
2chmod 0755 /run/sshd
2. mpirun 无输出或任务挂起
常见原因:
- Worker Pod 中
sshd未运行。 - SSH 端口未监听。
- SSH 认证失败。
排查命令:
1ps aux | grep sshd
2ss -lntp | grep :22
3. SSH 认证失败:Permission denied (publickey)
建议配置:
- 使用 root 用户。
- 确认
/root/.ssh/id_rsa存在。 - 确认
/root/.ssh/authorized_keys已配置公钥。 - 在
sshd_config中关闭StrictModes。
4. 禁止 root 运行
错误信息如下:
1mpirun has detected an attempt to run as root解决方案:在启动命令中添加如下参数:
1--allow-run-as-root5. MPI 环境中错误使用 DeepSpeed 启动
MPI 已负责进程管理和 rank 分配。如果再次使用 DeepSpeed 启动器,会导致二次进程拉起和 rank 冲突。
1# 正确做法
2mpirun -np 8 python train.py
3
4# 错误做法
5mpirun -np 8 deepspeed train.py
关键:MPI 模式下,DeepSpeed 只作为训练库使用,需要禁用其启动器功能。
6. mpirun 直接执行 shell 脚本失败
mpirun 不会自动解析脚本解释器,远程节点可能无法识别脚本格式,需要显式指定 bash 解释器执行脚本。
1# 正确做法
2mpirun -np 8 bash run.sh
3
4# 错误做法
5mpirun -np 8 run.sh
建议在脚本首行添加如下内容,确保使用 bash 而非 sh。
1#!/usr/bin/env bash评价此篇文章