

RLinf v0.4 基于RL的仿真-真机协同训练
RLinf v0.4 基于RL的仿真-真机协同训练
概述
RLinf 是一个面向 Embodied AI(具身智能) 和 Agentic AI(智能体 AI) 的开源强化学习基础框架。
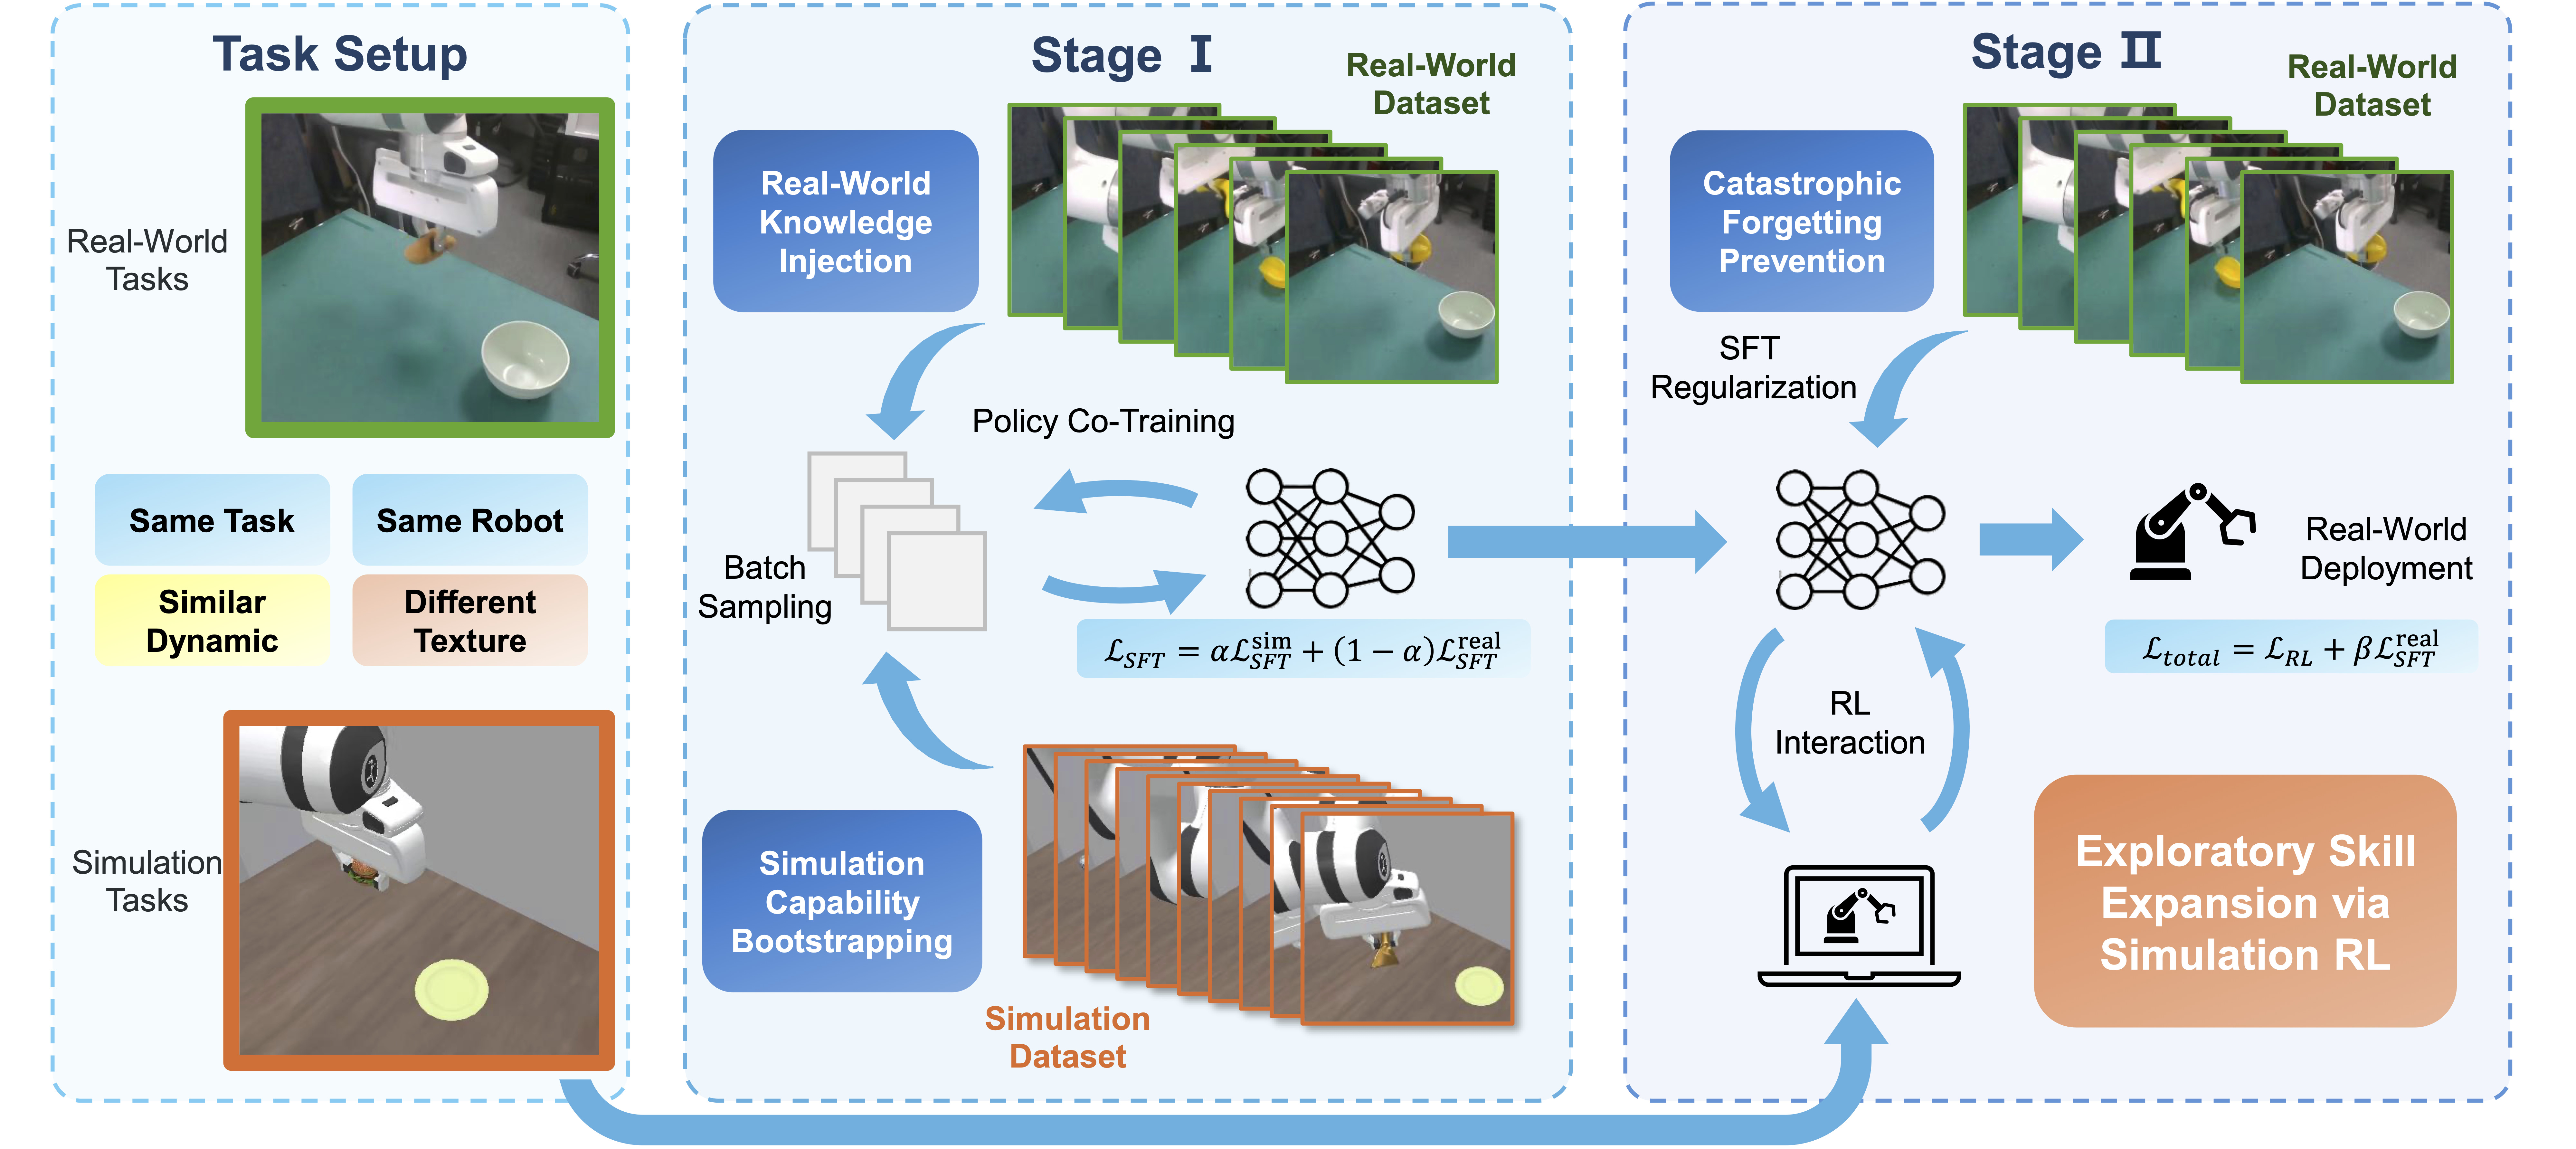
仿真-真机协同训练(RL-Co)把两种训练信号放进同一个优化循环:在仿真环境中用 PPO 做强化学习,同时在真机轨迹上做 SFT。这样可以提升仿真任务的成功率,同时保留真机数据带来的先验,避免策略只在仿真里过拟合、削弱 sim-to-real 迁移效果。技术细节可参考论文 Beyond Imitation: RL-Based Sim-Real Co-Training for VLA Models。
通过百舸快速开始,您可以使用开发机调试部署 RLinf v0.4,基于 ManiSkill 数字孪生环境和 50 条真机轨迹,对 π0.5 模型进行两阶段协同训练,并通过 TensorBoard、Ray Dashboard、训练日志和 GPU 指标监控训练进展。
| 项目 | 说明 |
|---|---|
| 算法 | PPO + SFT(RL-Co) |
| 模型 | π0.5 |
| 环境 / 数据 | ManiSkill 数字孪生 PandaPutOnPlateInScene25DigitalTwin-v1 + 50 条真机轨迹 |
| 训练流程 | 阶段一 SFT 预训练 → 阶段二 仿真-真机协同 RL 训练 |
| 配置文件 | examples/embodiment/config/maniskill_ppo_co_training_openpi_pi05.yaml |
适用场景
- 使用少量真机数据和对齐的仿真数字孪生,训练抓取放置类机器人策略模型。
- 在 PPO 强化学习中引入真机 SFT 约束,缓解纯仿真 RL 带来的 sim-to-real 退化。
- 复现官方
maniskill_ppo_co_training_openpi_pi05示例,或迁移到自己的机器人与仿真场景。 - 在单机开发机上排查调试 ManiSkill 资产、OpenPI 数据加载、norm stats、Ray 和 TensorBoard 相关训练问题。
- 观察
train/ppo_loss、train/sft_loss与train/loss_ratio,调整sft_loss_weight平衡 RL 与 SFT。
任务说明
本示例仅提供一个演示任务。用于自己的机器人时,需要采集真机数据并构建与之对齐的仿真场景。
| 部分 | 说明 |
|---|---|
| 任务 | 抓取放置:将桌上的物体放入碗中 |
| 真机 | Franka Emika Panda + RealSense;第三人称 RGB(640×480);7 自由度动作(x, y, z, roll, pitch, yaw, 夹爪) |
| 仿真 | 基于 ManiSkill3 的数字孪生,在布局、相机视角、任务逻辑、语言与动作空间上与真机对齐;动力学经过调校以逼近真实物理 |
| 真机数据 | LeRobot v2.1 格式,50 条轨迹、3937 帧、fps=5,state / actions 均为 7 维 |
训练规格参考 & 环境配置
推荐训练配置如下:
| 项目 | 推荐配置 |
|---|---|
| GPU | 单机 8 卡,建议单卡 80GiB 以上显存; |
| CPU | 建议 64 核以上,ManiSkill GPU 仿真与 Ray worker 会占用较多 CPU |
| 容器内存 | 建议 512GiB 以上 |
| 共享内存 | 建议 --shm-size 不小于 20G(与官方 Docker 启动参数一致) |
| 存储空间 | 模型、数据与资产约 26G(混合数据集 15.5G、SFT 权重 7.5G、真机数据 2.5G);每个 checkpoint 实测约 16G,100 步存 2 个、1000 步存 20 个,完整训练建议预留 400G 以上 |
项目目录配置如下表所示:
| 项目 | 推荐配置 |
|---|---|
| Python 环境 | 镜像内 source switch_env openpi;自定义环境为 /root/workspace/RLinf/.venv |
| 工作目录 | /root/workspace/RLinf |
| 训练入口 | /root/workspace/RLinf/examples/embodiment/train_embodied_agent.py |
| 训练配置 | /root/workspace/RLinf/examples/embodiment/config/maniskill_ppo_co_training_openpi_pi05.yaml |
| ManiSkill 资产 | /root/workspace/RLinf/rlinf/envs/sim/maniskill/assets |
| 模型目录 | /root/workspace/models |
| 数据集目录 | /root/workspace/datasets |
| 日志目录 | /root/workspace/logs |
预期效果参考
以下结果来自 RLinf 官方示例:
| 阶段 | 仿真成功率(env/success_once) |
|---|---|
| 加载阶段一 SFT 权重,零样本 | 约 35% |
| 阶段二协同训练 100 步后 | 约 50% |
| 效果提升 | 约 +15% |
真机部署效果和消融实验见论文 Beyond Imitation: Reinforcement Learning-Based Sim-Real Co-Training for VLA Models。
百舸实测(8×B30Z,官方复现 100 步)
环境:单机 8 卡 B30Z(275G),镜像内 openpi 环境,RLinf commit 91a302e,配置 maniskill_ppo_co_training_openpi_pi05,仅追加 runner.max_steps=100 与三个路径 override。训练正常退出,无报错、无 OOM。
| 项 | 实测值 |
|---|---|
| 总耗时 | 100 步约 4.71 小时 |
| step 0 | 277s(含首次加载) |
| 普通步 | 平均约 160s(rollout 约 137s + actor 训练约 22s + 权重同步约 2s) |
| 评测步(每 10 步) | 约 235s,评测本身约 76s |
| 评测 + 存盘步(第 50、100 步) | 约 275–280s,每个 checkpoint 约 16G |
| 显存 | 约 31G/卡 |
训练 env/success_once |
前 10 步均值 0.357 → 最后 10 步均值 0.516 |
评测 eval/success_once(64 条轨迹) |
第 10 步 0.50 → 第 100 步 0.75 |
评测 eval/success_at_end |
第 10 步 0.344 → 第 100 步 0.578 |
各评测点 eval/success_once:0.50、0.50、0.5625、0.5625、0.609、0.6875、0.6875、0.6875、0.719、0.75。训练侧成功率从约 35% 升到约 52%,与官方示例一致。train/loss_ratio 常态 0.1–2.7,偶有单步尖峰(实测 18.8、4.0),下一步即回落,不影响训练。
准备工作
如果您所在网络环境访问 HuggingFace 或 GitHub 较慢,建议提前配置 HuggingFace 镜像源,或配置代理加速。
huggingface 镜像配置:
1export HF_ENDPOINT=https://hf-mirror.com
2export HF_HUB_ENABLE_HF_TRANSFER=1
百舸平台已提供 ManiSkill 基础资产(carrot/)、SFT 权重和真机数据的 BOS 副本,可直接从 BOS 下载到训练任务的工作目录;只有约 4.5MB 的本示例专用资产 custom_assets/ 需从 HuggingFace 下载。实测 BOS 拉取 7.5G 权重约 30 秒,HuggingFace 拉取 2.5G 真机数据约 7 分钟。
| 资源 | BOS 路径(目录必须带结尾 /) |
实测规模 |
|---|---|---|
| SFT 权重 | bos:/aihc-models-bj/RLinf/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT/ |
4 个对象,model.safetensors 7,473,091,464 字节 |
| 真机数据 | bos:/aihc-rdw-bj/huggingface.co/datasets/RLinf/RLCo-Example-Real-Data/ |
156 个对象,约 2.5G |
| ManiSkill 基础资产 | bos:/aihc-rdw-bj/RLinf/maniskill_assets/carrot/ |
132 个对象,约 84M |
环境说明
说明:本文中的路径均以百舸训练任务内的
/root/workspace为例。实际使用时,可根据任务挂载目录调整。
本文使用以下目录:
1/root/workspace/RLinf
2/root/workspace/RLinf/rlinf/envs/sim/maniskill/assets
3/root/workspace/models
4/root/workspace/datasets
5/root/workspace/logs
步骤一:准备 ManiSkill 资产
本示例需要两部分资产:ManiSkill 基础资产 carrot/(胡萝卜、盘子、桌面三类模型)和本示例专用资产 custom_assets/bridge_table_long.glb。环境默认从 rlinf/envs/sim/maniskill/assets 加载资产,也可以通过环境变量 MANISKILL_ASSET_DIR 指向其他目录。
说明:
partnet_mobility/在本示例中不被引用(rlinf/代码内零引用),无需下载;ManiSkill 自带的内置数据位于~/.maniskill,镜像已预置。
最终目录结构应为:
1/root/workspace/RLinf/rlinf/envs/sim/maniskill/assets/
2├── carrot/
3│   ├── more_carrot/   # 含 model_db.json
4│   ├── more_plate/    # 含 model_db.json
5│   └── more_table/    # 含 model_db.json 与 imgs/
6└── custom_assets/
7    └── bridge_table_long.glb
方式一:通过 BOS 下载基础资产(推荐)
只需拉取 carrot/ 子目录(实测 132 个对象、约 84M):
1ASSET_DIR=/root/workspace/RLinf/rlinf/envs/sim/maniskill/assets
2mkdir -p "$ASSET_DIR/carrot"
3bcecmd bos cp -r bos:/aihc-rdw-bj/RLinf/maniskill_assets/carrot/ "$ASSET_DIR/carrot/"
如果 bcecmd 报 Object don't exist,先确认真实目录和结尾 /(必须带 -a,否则只列前 1000 条且不报错):
1bcecmd bos ls -a bos:/aihc-rdw-bj/RLinf/maniskill_assets/方式二:通过 HuggingFace 下载基础资产
先测试 HuggingFace 连通性,直连可用时不必设置镜像源:
1curl -sS -o /dev/null -w '%{http_code}\n' --max-time 10 https://huggingface.co   # 200 即可直连
2# 不通时再执行:export HF_ENDPOINT=https://hf-mirror.com
3cd /root/workspace
4hf download --repo-type dataset RLinf/maniskill_assets --include "carrot/*" --local-dir ./maniskill_assets
5cp -r ./maniskill_assets/carrot /root/workspace/RLinf/rlinf/envs/sim/maniskill/assets/
下载本示例专用资产
RLinf/RLCo-maniskill-assets 仓库只包含 custom_assets/bridge_table_long.glb(4,471,172 字节),需从 HuggingFace 下载:
1cd /root/workspace/RLinf/rlinf/envs/sim/maniskill/assets
2hf download --repo-type dataset RLinf/RLCo-maniskill-assets --include "custom_assets/*" --local-dir .
验证资产目录:
1ASSET_DIR=/root/workspace/RLinf/rlinf/envs/sim/maniskill/assets
2for d in more_carrot more_plate more_table; do
3  ls -l "$ASSET_DIR/carrot/$d/model_db.json" || echo "MISSING carrot/$d/model_db.json"
4done
5ls -l "$ASSET_DIR/custom_assets/bridge_table_long.glb"   # 预期 4471172 字节
步骤二:准备模型权重与数据
协同训练分为两个阶段:
| 阶段 | 内容 | 所需资源 |
|---|---|---|
| 阶段一:SFT 预训练 | 用真机 + 仿真混合数据做监督学习,快速注入真机与仿真知识 | 混合数据集 RLinf/RLCo-Example-Mix-Data(50 条真机 + 1499 条仿真轨迹,约 15.5G) |
| 阶段二:协同 RL 训练 | 在 PPO 训练循环中加入真机 SFT 损失 | 阶段一 SFT 权重 + 真机数据 RLinf/RLCo-Example-Real-Data(50 条轨迹,约 2.5G) |
阶段一可以自行训练,也可以直接使用官方 SFT 权重。快速复现建议直接下载 SFT 权重,跳过阶段一。
方式一:从 BOS 下载 SFT 权重与真机数据(推荐)
建议放入 tmux 执行,下载完成后逐文件对账大小(bcecmd 打印的 [N] objects downloaded 不能证明文件完整):
1mkdir -p /root/workspace/models /root/workspace/datasets /root/workspace/logs
2cat > /tmp/bos_download_rlco.sh <<'EOF'
3#!/usr/bin/env bash
4set -euo pipefail
5M=/root/workspace/models/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
6D=/root/workspace/datasets/RLCo-Example-Real-Data
7MB=bos:/aihc-models-bj/RLinf/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT/
8DB=bos:/aihc-rdw-bj/huggingface.co/datasets/RLinf/RLCo-Example-Real-Data/
9# 逐文件对账:BOS 列表中的每个对象都必须在本地存在且大小一致
10rec() { bcecmd bos ls -a -r "$1" | awk '{print $3, $NF}' | while read sz key; do
11  f="$2/$key"; [ -f "$f" ] && [ "$(stat -c %s "$f")" = "$sz" ] || echo "BAD $key bos=$sz"; done; }
12{
13  date
14  mkdir -p "$M" "$D"
15  bcecmd bos cp -r "$MB" "$M/"
16  bcecmd bos cp -r "$DB" "$D/"
17  echo "reconcile model:"; rec "$MB" "$M"
18  echo "reconcile data:";  rec "$DB" "$D"
19  echo "download done"; date
20} 2>&1 | tee -a /root/workspace/logs/bos_download_rlco.log
21EOF
22chmod +x /tmp/bos_download_rlco.sh
23tmux new-session -d -s bos_download_rlco /tmp/bos_download_rlco.sh查看进度与对账结果(reconcile 段之后没有 BAD 行即为完整):
1tail -20 /root/workspace/logs/bos_download_rlco.log
2du -sh /root/workspace/models/* /root/workspace/datasets/* 2>/dev/null || true
说明:对账函数中
awk '{print $3, $NF}'依赖bcecmd bos ls -a -r的输出列(第 3 列为大小、最后一列为相对 key)。若 BOS 列表只看到少量小文件,可能是上传尚未完成,以ls -a -r的完整列表为准。bcecmd不支持bos du,统计体积请用ls -a -r累加。
方式二:从 HuggingFace 下载 SFT 权重与真机数据
1export HF_ENDPOINT=https://hf-mirror.com
2export HF_HUB_ENABLE_HF_TRANSFER=1
3mkdir -p /root/workspace/models /root/workspace/datasets /root/workspace/logs
4
5hf download RLinf/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT \
6  --local-dir /root/workspace/models/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
7
8hf download --repo-type dataset RLinf/RLCo-Example-Real-Data \
9  --local-dir /root/workspace/datasets/RLCo-Example-Real-Data
建议放入 tmux 并持续检查结果:
1SESSION=hf_download_rlco
2cat > /tmp/download_rlco.sh <<'EOF'
3#!/usr/bin/env bash
4set -euo pipefail
5export HF_ENDPOINT=https://hf-mirror.com
6export HF_HUB_ENABLE_HF_TRANSFER=1
7{
8  date
9  echo "download sft model start"
10  hf download RLinf/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT \
11    --local-dir /root/workspace/models/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
12  echo "download real data start"
13  hf download --repo-type dataset RLinf/RLCo-Example-Real-Data \
14    --local-dir /root/workspace/datasets/RLCo-Example-Real-Data
15  echo "download done"
16  date
17} 2>&1 | tee -a /root/workspace/logs/hf_download_rlco.log
18EOF
19chmod +x /tmp/download_rlco.sh
20tmux new-session -d -s "$SESSION" /tmp/download_rlco.sh
查看下载进度:
1tmux ls 2>/dev/null | grep hf_download_rlco || true
2tail -50 /root/workspace/logs/hf_download_rlco.log
3du -sh /root/workspace/models/* /root/workspace/datasets/* 2>/dev/null || true
方式三:自行训练阶段一 SFT
下载混合数据集:
1export HF_ENDPOINT=https://hf-mirror.com
2hf download --repo-type dataset RLinf/RLCo-Example-Mix-Data \
3  --local-dir /root/workspace/datasets/RLCo-Example-Mix-Data
训练方法请参考 OpenPI 官方代码 或 RLinf 文档的 监督训练微调 章节。阶段一与阶段二使用同一个 OpenPI 配置名 pi05_maniskill_sim_real_co_training(定义在 rlinf/models/embodiment/openpi/dataconfig/__init__.py),需确保模型结构与 normalization 统计量在两个阶段保持一致。自训权重目录需与官方 SFT 权重保持相同结构(见下文验证)。
验证模型与数据目录
SFT 权重目录中除 model.safetensors 外,还必须包含 norm stats;阶段二会按原始 asset_id(physical-intelligence/pick_and_place_real)从模型目录加载它:
1MODEL=/root/workspace/models/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
2ls -l "$MODEL"/model.safetensors "$MODEL"/metadata.pt   # model.safetensors 预期 7473091464 字节
3ls -lh "$MODEL"/physical-intelligence/pick_and_place_real/norm_stats.json
真机数据下载后,LeRobot 数据集根目录(包含 meta/info.json 的目录)位于仓库内的子目录:
1SFT_DATA=/root/workspace/datasets/RLCo-Example-Real-Data/physical-intelligence/pick_and_place_real
2ls "$SFT_DATA"
3ls "$SFT_DATA"/meta
4ls "$SFT_DATA"/data/chunk-000 | wc -l     # 预期 50
5python -c "import json; d=json.load(open('$SFT_DATA/meta/info.json')); print(d['total_episodes'], d['total_frames'], d['fps'])"
6# 预期输出:50 3937 5
步骤三:确认训练配置
以 maniskill_ppo_co_training_openpi_pi05 为例,核心配置如下:
1cluster:
2  num_nodes: 1
3  component_placement:
4    actor,env,rollout: all
5
6runner:
7  max_epochs: 1000
8  val_check_interval: 10
9  save_interval: 50
10
11algorithm:
12  adv_type: gae
13  loss_type: actor_critic
14  reward_type: chunk_level
15  update_epoch: 2
16  entropy_bonus: 0.005
17  clip_ratio_high: 0.2
18  clip_ratio_low: 0.2
19  gamma: 0.99
20  gae_lambda: 0.95
21
22env:
23  train:
24    rollout_epoch: 2
25    total_num_envs: 64
26    max_episode_steps: 80
27  eval:
28    total_num_envs: 64
29
30actor:
31  micro_batch_size: 40
32  global_batch_size: 2560
33  enable_sft_co_train: True
34  sft_loss_weight: 0.2
35  sft_data_path: "/path/to/RLCo-Example-Real-Data"
36  model:
37    model_path: "/path/to/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT"
38    add_value_head: True
39    num_action_chunks: 4
40    openpi:
41      config_name: "pi05_maniskill_sim_real_co_training"
42      noise_method: "flow_noise"
43      action_horizon: 8
44  optim:
45    lr: 4e-6
46    value_lr: 2e-4
47
48rollout:
49  model:
50    model_path: "/path/to/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT"
关键参数说明:
| 参数 | 说明 |
|---|---|
actor.enable_sft_co_train |
设为 True 开启协同训练;设为 False 则退化为纯 PPO 训练 |
actor.sft_loss_weight |
SFT 损失权重 β,总损失为 L_total = L_PPO + β · L_SFT,默认 0.2 |
actor.sft_data_path |
真机 LeRobot 数据集根目录,必须是包含 meta/info.json 的那一层目录 |
actor.model.openpi.config_name |
OpenPI 数据配置名 pi05_maniskill_sim_real_co_training,决定数据变换与 norm stats 的 asset_id |
actor.model.model_path / rollout.model.model_path |
都指向阶段一 SFT 权重目录,norm stats 也从该目录加载 |
actor.global_batch_size / actor.micro_batch_size |
每次参数更新的 PPO 样本数 / 每卡单次前向样本数;8 卡下梯度累积步数为 2560 / (40 × 8) = 8 |
runner.max_epochs |
每个 epoch 对应 1 个 global step,默认 1000;复现官方 100 步结果可用 runner.max_steps=100 |
runner.val_check_interval / runner.save_interval |
每 10 步评测、每 50 步保存;最后一步无论是否整除都会评测并保存;save_interval 必须能被 val_check_interval 整除 |
PPO 样本数与 batch 的对应关系:64 个并行环境 × 2 个 rollout_epoch × 每个 episode 20 个 action chunk(80 步 / 4)= 2560,正好是一个 global_batch_size。如果修改 total_num_envs、rollout_epoch 或卡数,需要同步调整 global_batch_size,并保证它能被 micro_batch_size × GPU 数 整除。
SFT 分支每个 micro step 从真机数据中取一个 batch:pi05_maniskill_sim_real_co_training 的 batch_size=16,按 8 卡均分后每卡每次 2 条样本;数据迭代完一轮后会自动进入下一个 epoch。
原始 YAML 中模型路径和数据路径都是占位符:
1/path/to/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
2/path/to/RLCo-Example-Real-Data
实际启动时请通过 Hydra CLI override 注入真实路径。注意 sft_data_path 要指向仓库内的子目录:
1rollout.model.model_path=/root/workspace/models/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
2actor.model.model_path=/root/workspace/models/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
3actor.sft_data_path=/root/workspace/datasets/RLCo-Example-Real-Data/physical-intelligence/pick_and_place_real
官方 run_embodiment.sh 只透传 STEPS、SAVE_INTER、NODES 三个环境变量,不支持追加任意 Hydra override,因此下文使用直接 Python 入口启动。如果您更习惯用官方脚本,需要先把上述三个路径改写进 YAML。
推荐参数分档
| 档位 | 参数 | 用途 |
|---|---|---|
| 冒烟验证 | runner.max_steps=2 runner.val_check_interval=-1 runner.save_interval=-1 |
首次运行,确认资产、数据、norm stats、Ray 全链路可用;关闭评测与存盘(否则最后一步会强制评测并保存) |
| 官方复现 | runner.max_steps=100 |
对齐官方示例,观察 env/success_once 从约 35% 上升到约 50%;8×B30Z 实测约 4.7 小时 |
| 完整训练 | 不追加 override(max_epochs=1000) |
长时间训练,按 save_interval=50 保存 checkpoint;8×B30Z 按实测外推约 47 小时,checkpoint 合计约 320G |
| 纯 PPO 对照 | actor.enable_sft_co_train=False |
消融对照,观察去掉真机 SFT 约束后的表现 |
| 调整 SFT 权重 | actor.sft_loss_weight=0.1 或 0.5 |
train/loss_ratio 持续过大时降低,真机先验保持不足时适当提高 |
步骤四:启动训练
建议使用 tmux 启动训练,避免 SSH 断开导致任务中止。
以下命令使用官方复现档(100 步)启动。首次运行建议先把 EXTRA 改为冒烟验证档,确认链路正常后再正式启动。
1cd /root/workspace/RLinf
2
3SESSION=rlco_train
4CONFIG=maniskill_ppo_co_training_openpi_pi05
5MODEL=/root/workspace/models/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
6SFT_DATA=/root/workspace/datasets/RLCo-Example-Real-Data/physical-intelligence/pick_and_place_real
7EXTRA="runner.max_steps=100"
8# 冒烟验证:EXTRA="runner.max_steps=2 runner.val_check_interval=-1 runner.save_interval=-1"
9START_SCRIPT=/tmp/start_rlco_train.sh
10
11LOG_DIR=/root/workspace/logs/$(date +%Y%m%d-%H:%M:%S)-${CONFIG}
12LOG_FILE=${LOG_DIR}/run_embodiment.log
13mkdir -p "$LOG_DIR"
14
15cat > "$START_SCRIPT" <<EOF
16#!/usr/bin/env bash
17set -e
18cd /root/workspace/RLinf
19# 使用官方镜像时激活 openpi 环境;自定义环境改为 source /root/workspace/RLinf/.venv/bin/activate
20source switch_env openpi
21export EMBODIED_PATH=/root/workspace/RLinf/examples/embodiment
22export REPO_PATH=/root/workspace/RLinf
23export PYTHONPATH=/root/workspace/RLinf:\$PYTHONPATH
24export MUJOCO_GL=egl
25export PYOPENGL_PLATFORM=egl
26export MANISKILL_ASSET_DIR=/root/workspace/RLinf/rlinf/envs/sim/maniskill/assets
27export RAY_memory_usage_threshold=0.98
28export TOKENIZERS_PARALLELISM=false
29CMD="python /root/workspace/RLinf/examples/embodiment/train_embodied_agent.py --config-path /root/workspace/RLinf/examples/embodiment/config/ --config-name ${CONFIG} runner.logger.log_path=${LOG_DIR} rollout.model.model_path=${MODEL} actor.model.model_path=${MODEL} actor.sft_data_path=${SFT_DATA} ${EXTRA}"
30echo "\$CMD" > ${LOG_FILE}
31echo "LOG_DIR=${LOG_DIR}" >> ${LOG_FILE}
32echo "MODEL=${MODEL}" >> ${LOG_FILE}
33echo "SFT_DATA=${SFT_DATA}" >> ${LOG_FILE}
34\$CMD 2>&1 | tee -a ${LOG_FILE}
35EOF
36
37chmod +x "$START_SCRIPT"
38
39if tmux has-session -t "$SESSION" 2>/dev/null; then
40  tmux kill-session -t "$SESSION"
41fi
42
43tmux new-session -d -s "$SESSION" "$START_SCRIPT"
44printf "session=%s\nlog=%s\n" "$SESSION" "$LOG_FILE"
启动前建议先做一次路径预检,避免训练拉起 Ray 后才报错:
1MODEL=/root/workspace/models/RLinf-Pi05-RLCo-PandaPutOnPlateInScene25DigitalTwin-V1-SFT
2SFT_DATA=/root/workspace/datasets/RLCo-Example-Real-Data/physical-intelligence/pick_and_place_real
3ASSET_DIR=/root/workspace/RLinf/rlinf/envs/sim/maniskill/assets
4for f in \
5  "$MODEL/model.safetensors" \
6  "$MODEL/physical-intelligence/pick_and_place_real/norm_stats.json" \
7  "$SFT_DATA/meta/info.json" \
8  "$ASSET_DIR/carrot/more_carrot/model_db.json" \
9  "$ASSET_DIR/carrot/more_plate/model_db.json" \
10  "$ASSET_DIR/carrot/more_table/model_db.json" \
11  "$ASSET_DIR/custom_assets/bridge_table_long.glb"
12do
13  [ -f "$f" ] && echo "OK   $f" || echo "MISS $f"
14done
15df -h /root/workspace   # 100 步约需 32G checkpoint 空间,完整训练约 320G
启动后验证点:
tmux ls中存在rlco_train。- 日志中
--config-name maniskill_ppo_co_training_openpi_pi05,且三个路径 override 均为真实路径。 - Hydra 配置中
enable_sft_co_train: true、config_name: pi05_maniskill_sim_real_co_training。 - Ray 启动并识别 1 node / 8 accelerators。
- 无
Traceback、FileNotFoundError、RayOutOfMemory、worker died。 - 第一个 global step 完成后(实测约 277s),TensorBoard 中出现
sft_loss、ppo_loss、loss_ratio指标;实测 step 0env/success_once为 0.359,与官方零样本约 35% 吻合。
训练启动后建议立即打开 TensorBoard 和 Ray Dashboard:
1ssh -p <port> -L 6006:127.0.0.1:6006 -L 18265:127.0.0.1:8265 root@<host>重点查看:
- TensorBoard:
env/success_once、env/return、eval/success_once、train/ppo_loss、train/sft_loss、train/loss_ratio、train/actor/total_loss - Ray Dashboard:actor/rollout/env worker 状态、CPU/GPU 使用、异常 worker
- 主日志:rollout 进度、
global_step、SFT/PPO loss imbalance detected告警、异常栈
步骤五:监控训练
查看主日志:
1tail -f /root/workspace/logs/<run-dir>/run_embodiment.log提取关键进展:
1grep -nE 'Generating Rollout Epochs|global_step|success_once|sft_loss|ppo_loss|loss imbalance|Traceback|Exception|FileNotFoundError|RayOutOfMemory|worker died' \
2  /root/workspace/logs/<run-dir>/run_embodiment.log | tail -100
查看 GPU:
1watch -n 2 'nvidia-smi --query-gpu=index,utilization.gpu,memory.used,memory.total --format=csv,noheader,nounits'查看 cgroup 内存和 OOM:
1watch -n 2 'cat /sys/fs/cgroup/memory.current; cat /sys/fs/cgroup/memory.max; cat /sys/fs/cgroup/memory.events'查看 Ray worker:
1ps -eo pid,stat,pcpu,pmem,rss,args --sort=-pcpu | \
2 grep -E 'train_embodied_agent.py|ray::EmbodiedFSDPActor|ray::MultiStepRolloutWorker|ray::EnvWorker' | grep -v grep | head -30查看评测视频(env.eval.video_cfg.save_video=True,每次评测后按 seed 分目录写入;实测 100 步共 8 个 seed_* 目录、约 63M):
1ls -lt /root/workspace/logs/<run-dir>/video/eval | head训练结束判据(三项同时满足):tmux 会话已退出、日志无 Traceback、checkpoint 目录出现最后一步。实测目录结构:
1/root/workspace/logs/<run-dir>/
2├── run_embodiment.log
3├── metrics.log
4├── tensorboard/
5├── video/eval/seed_*/
6└── maniskill_ppo_co_training_openpi_pi05/checkpoints/
7    ├── global_step_50/actor/{dcp_checkpoint,model_state_dict}   # 约 16G
8    └── global_step_100/                                         # 约 16G
步骤六:启动 TensorBoard 和 Ray Dashboard(可选)
启动 TensorBoard:
1cd /root/workspace/RLinf
2tmux new-session -d -s tensorboard_rlinf \
3  'source switch_env openpi && tensorboard --logdir /root/workspace/logs --port 6006 --host 127.0.0.1'
本地访问:
1ssh -p <port> -L 6006:127.0.0.1:6006 root@<host>浏览器打开:
1http://127.0.0.1:6006Ray Dashboard 远端默认监听:
1127.0.0.1:8265本地访问:
1ssh -p <port> -L 18265:127.0.0.1:8265 root@<host>浏览器打开:
1http://127.0.0.1:18265远端验证 Ray Dashboard:
1curl -s http://127.0.0.1:8265/api/version步骤七:解析 TensorBoard 指标
使用脚本读取 TensorBoard scalar:
1cd /root/workspace/RLinf
2source switch_env openpi
3export TF_CPP_MIN_LOG_LEVEL=3
4
5python - <<'PY'
6from pathlib import Path
7from tensorboard.backend.event_processing.event_accumulator import EventAccumulator
8run = Path('/root/workspace/logs/<run-dir>')
9for event in sorted((run / 'tensorboard').glob('events.out.tfevents.*')):
10    print(f'EVENT {event.name} size={event.stat().st_size}')
11    ea = EventAccumulator(str(event), size_guidance={'scalars': 0})
12    ea.Reload()
13    for tag in sorted(ea.Tags().get('scalars', [])):
14        vals = ea.Scalars(tag)
15        if vals:
16            v = vals[-1]
17            print(f'{tag}\tcount={len(vals)}\tstep={v.step}\tvalue={v.value}')
18PY
重点关注:
env/success_once:训练 rollout 的仿真成功率,官方示例从约 0.35 上升到约 0.50(百舸实测 0.359 → 0.523)eval/success_once/eval/success_at_end:每 10 步评测的仿真成功率(百舸实测 0.50 → 0.75 / 0.344 → 0.578)env/returntrain/ppo_loss:PPO(RL)损失train/sft_loss:真机数据上的 SFT 损失train/loss_ratio:SFT 损失与 PPO 损失的量级比train/actor/total_loss:L_PPO + β · L_SFT(已除以梯度累积步数)train/actor/approx_kltrain/actor/grad_normtime/actor/run_training
协同训练相关指标的判读:
| 指标 | 正常表现 | 异常信号与处理 |
|---|---|---|
train/sft_loss |
在 SFT 权重基础上维持较低水平,随训练小幅波动 | 持续上升说明策略在偏离真机分布,可适当提高 sft_loss_weight |
train/ppo_loss |
绝对值较小,随 rollout 波动 | 长期接近 0 会使 loss_ratio 剧烈放大 |
train/loss_ratio |
量级稳定(实测常态 0.1–2.7,偶发单步尖峰后即回落) | 持续多步高位,或大于 1e5 时日志打印 SFT/PPO loss imbalance detected,应降低 sft_loss_weight |
env/success_once |
前 100 步呈上升趋势 | 长期不升可做 enable_sft_co_train=False 对照,排除 SFT 约束过强 |
说明:当前代码中
train/loss_ratio按|L_SFT| / |L_PPO|计算,未乘 β;官方文档公式为β·|L_SFT| / |L_PPO|。判读量级时以实际日志为准。
百舸实测关键指标(repro100,step 99 终值)
| 指标 | 值 |
|---|---|
eval/success_once |
0.75(第 10 步 0.50) |
eval/success_at_end |
0.5781(第 10 步 0.3438) |
env/success_once |
0.5234(step 0 为 0.3594;最后 10 步均值 0.516,最高 0.5703) |
env/success_at_end |
0.375(step 0 为 0.2656) |
env/return |
0.6188(step 0 为 0.4359) |
env/num_trajectories / env/episode_len |
128 / 80 |
train/sft_loss |
0.01245(step 0 为 0.0070,最高 0.0156) |
train/ppo_loss |
0.0224(step 0 为 0.7557) |
train/loss_ratio |
0.287(常态 0.1–2.7;step 69 单步 18.8、step 85 单步 4.0) |
train/actor/approx_kl |
0.0067(全程 0.005–0.011) |
train/actor/clip_fraction |
0.0018 |
train/actor/grad_norm |
2.735(step 0 为 49.9,前 10 步均值 11.6,最后 10 步均值 3.8) |
train/critic/explained_variance |
0.636(step 0 为 -8.5) |
train/critic/value_loss |
0.0204(step 0 为 0.758) |
SFT/PPO loss imbalance detected 告警 |
0 次 |
各评测点(每次 64 条轨迹):
| 步数 | 10 | 20 | 30 | 40 | 50 | 60 | 70 | 80 | 90 | 100 |
|---|---|---|---|---|---|---|---|---|---|---|
eval/success_once |
0.500 | 0.500 | 0.563 | 0.563 | 0.609 | 0.688 | 0.688 | 0.688 | 0.719 | 0.750 |
eval/success_at_end |
0.344 | 0.422 | 0.438 | 0.391 | 0.469 | 0.469 | 0.531 | 0.516 | 0.578 | 0.578 |
success_once 与 success_at_end 的区别:本任务配置 ignore_terminations: True、auto_reset: False,每条轨迹固定跑满 80 步。success_once 统计 80 步内任一时刻满足成功条件(胡萝卜 xy 落在盘子范围内、与盘子接触且接触力超过阈值),success_at_end 只看最后一步是否仍满足。两者差值约 0.16–0.17,即 64 条中约 10–11 条曾放上盘子但随后滑落或被碰开。success_at_end 更接近真机部署关心的“放稳”效果。
性能参考(8×B30Z,repro100)
| 项 | 实测值 |
|---|---|
| 总墙钟 | 4.71 小时(00:00:34 – 04:46:05) |
| step 0 | 277s(含首次加载) |
| 普通步 | 平均 159.9s(155.7–164.6s):generate_rollouts 136.5s + actor_training 21.7s + sync_weights 1.7s |
| 评测步(第 10/20/…/90 步) | 233.6–240s,其中评测 75.6s |
| 评测 + 存盘步(第 50、100 步) | 280s / 274.5s |
| 显存 | 约 31G/卡 |
| checkpoint | 每个约 16G,100 步共约 32G |
| 完整训练外推 | 1000 步约 47 小时,20 个 checkpoint 约 320G |
rollout(ManiSkill GPU 仿真 + π0.5 推理)占普通步约 85%,actor 训练只占约 14%;换机型或调整 total_num_envs 时优先关注 rollout 耗时。
常见问题处理
| 问题 | 解决方案 |
|---|---|
模型或数据路径仍是 /path/to/... |
启动命令必须追加 rollout.model.model_path、actor.model.model_path、actor.sft_data_path 三个 override |
actor.sft_data_path must be set ... |
enable_sft_co_train=True 时必须设置 actor.sft_data_path |
加载真机数据时报 meta/info.json 不存在,或尝试从 HuggingFace 拉取 meta/ |
sft_data_path 指到了下载目录顶层,应改为 .../RLCo-Example-Real-Data/physical-intelligence/pick_and_place_real |
| 加载 norm stats 失败 | 检查 SFT 权重目录下是否存在 physical-intelligence/pick_and_place_real/norm_stats.json;自训阶段一权重需按同样结构放置 |
找不到 bridge_table_long.glb 或 carrot 资产 |
确认资产位于 rlinf/envs/sim/maniskill/assets,或设置 MANISKILL_ASSET_DIR 指向资产目录;custom_assets 需单独从 RLinf/RLCo-maniskill-assets 下载(该仓库不含 carrot,carrot 从 BOS 或 RLinf/maniskill_assets 获取) |
xxx is not divisible by yyy 断言失败 |
修改了 total_num_envs、rollout_epoch 或卡数后,需同步调整 global_batch_size,并保证能被 micro_batch_size × GPU 数 整除 |
save_interval must be divisible by val_check_interval |
两者需整除,或将 val_check_interval 设为 -1 关闭评测 |
日志出现 SFT/PPO loss imbalance detected |
PPO 损失过小或 SFT 损失过大,降低 sft_loss_weight(如 0.1),并观察 train/loss_ratio 是否回落 |
| Ray worker 被 memory killer 杀 | 检查 /sys/fs/cgroup/memory.max 和 /sys/fs/cgroup/memory.events,调大容器内存,或降低 env.train.total_num_envs 并同步调整 batch |
| rollout 阶段显存 OOM | 可开启 actor.enable_offload=True rollout.enable_offload=True,或降低 actor.micro_batch_size(需保持整除关系) |
| 主日志长时间无输出 | 先看 TensorBoard、GPU、worker CPU 与 Ray Dashboard,不要只凭主日志判断停止;必要时抓栈保留现场 |
| BOS 目录只列出少量小文件 | 上传可能尚未完成,或未带 -a 被截断在 1000 条;用 bcecmd bos ls -a -r <目录/> 查看完整列表后再下载 |
bcecmd bos du 报不支持 |
bcecmd 无 du 子命令,用 bcecmd bos ls -a -r 输出的大小列累加 |
bcecmd 显示 [N] objects downloaded 但训练加载失败 |
该提示不能证明文件完整,按步骤二的 rec 函数逐文件对账大小,有 BAD 行则重新下载对应文件 |
资产加载报 model_db.json 不存在 |
carrot/ 下 more_carrot、more_plate、more_table 三个子目录都需要各自的 model_db.json,只拷贝部分子目录会失败 |
| 每 10 步出现一次耗时约 235s 的长步 | 正常,为评测步(评测约 76s);第 50、100 步再叠加约 40s 存盘,约 275–280s |
train/loss_ratio 单步跳到 10 以上 |
实测 step 69 为 18.8、step 85 为 4.0,均在下一步回落;只有持续多步高位或出现 imbalance 告警才需降低 sft_loss_weight |
eval/success_at_end 明显低于 eval/success_once |
正常,前者要求最后一步仍放稳,实测差值约 0.16–0.17;两者同步上升即说明训练有效 |
评价此篇文章