

文档去手写V2
更新时间:2026-10-23
接口描述
文档去手写V2已正式商用!欢迎咨询合作了解详情,或立即购买快速开通服务。
用于去除图片中的手写内容并保留印刷体内容;V2版本采用更精细的版面分析,可精准识别并去除涂改、批注、笔记等手写痕迹,去除后印刷体笔画与版式完整保留,适用于试卷、文档、手稿、票据等场景的去手写还原与归档扫描。
V2主要提升
- 新增方向转正参数
enable_ori:适用于拍摄角度不正的场景,例如文档被横拍、倒置或旋转了一定角度,开启后自动识别并还原正确朝向,无需手动调整。 - 去除更彻底:无论是浅淡笔迹还是多种颜色的手写内容,都能更干净地清除,不留残影,视觉效果更整洁。
- 印刷内容更完整:去手写的同时对原文档"无损",文字、表格、线条、公式均完整保留。
- 画面更自然:处理后的区域与周围内容融合更自然,无明显色块或噪点,阅读体验流畅。
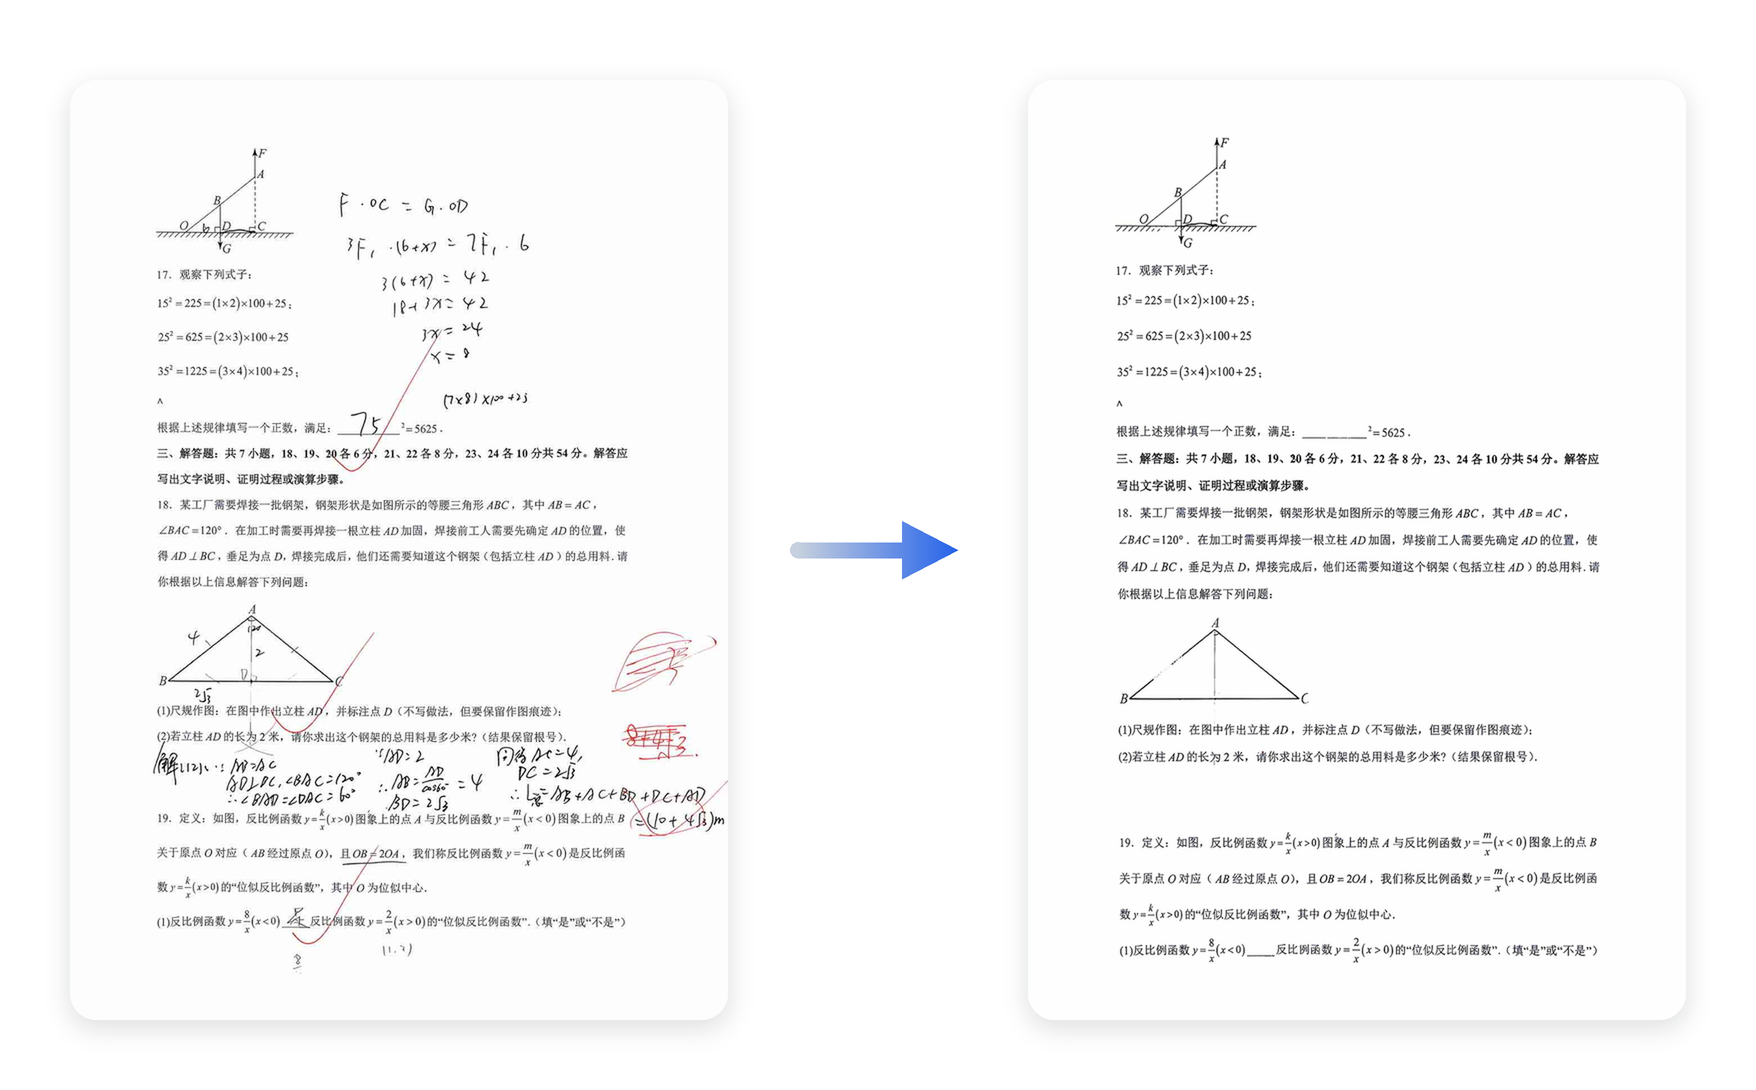
【免费额度与QPS规格】 实名认证后即可自动获取免费测试额度:
- 个人认证:共计赠送500次,2QPS
- 企业认证:共计赠送1000次,5QPS
QPS规格:付费用户初始容量为5QPS,可通过购买QPS叠加包进行扩容,购买QPS叠加包时需保证已开通按量后付费或购买次数包。
在线调试
您可以在 示例代码中心 中调试该接口,可进行签名验证、查看在线调用的请求内容和返回结果、示例代码的自动生成。
请求说明
请求示例
HTTP 方法: POST
请求URL: https://aip.baidubce.com/rest/2.0/ocr/v1/remove_handwriting_v2
URL参数:
| 参数 | 值 |
|---|---|
| access_token | 通过API Key和Secret Key获取的access_token,参考“Access Token获取” |
Header如下:
| 参数 | 值 |
|---|---|
| Content-Type | application/x-www-form-urlencoded |
Body中放置请求参数,参数详情如下:
请求参数
| 参数 | 类型 | 是否必须 | 说明 |
|---|---|---|---|
| image | string | 和 url/pdf_file 三选一 | 图像数据,base64编码后进行urlencode,要求base64编码和urlencode后大小不超过4M,最短边至少15px,最长边最大4096px,支持jpg/jpeg/png/bmp格式 优先级:image > url > pdf_file,当image字段存在时,url、pdf_file字段失效 |
| url | string | 和 image/pdf_file 三选一 | 图片完整url,url长度不超过1024字节,url对应的图片base64编码后大小不超过4M,最短边至少15px,最长边最大4096px,支持jpg/jpeg/png/bmp格式 优先级:image > url > pdf_file,当image字段存在时,url字段失效 请注意关闭URL防盗链 |
| pdf_file | string | 和 image/url 三选一 | PDF文件,base64编码后进行urlencode,要求base64编码和urlencode后大小不超过4M,最短边至少15px,最长边最大4096px 优先级:image > url > pdf_file,当image、url字段存在时,pdf_file字段失效 |
| pdf_file_num | string | 否 | 需要识别的PDF文件的对应页码,当 pdf_file 参数有效时,识别传入页码的对应页面内容,若不传入,则默认识别第 1 页 |
| enable_detect | bool | 否 | 是否去除文件边缘后再识别,默认为 true,可选值: - true:去除,适用于有背景/边缘的拍摄件 - false:不去除,适用于不含背景/边缘的扫描件 |
| enable_ori | int32 | 否 | 选择是否开启图像方向转正功能,可选值如下: - enable_ori=0,默认值,不开启转正; - enable_ori=1,开启转正 |
请求代码示例
提示一:使用示例代码前,请记得替换其中的示例Token、图片地址或Base64信息。
提示二:部分语言依赖的类或库,请在代码注释中查看下载地址。
1curl -i -k 'https://aip.baidubce.com/rest/2.0/ocr/v1/remove_handwriting_v2?access_token=【调用鉴权接口获取的token】' --data 'image=【图片Base64编码,需UrlEncode】&enable_detect=true&enable_ori=0' -H 'Content-Type:application/x-www-form-urlencoded'1# encoding:utf-8
2
3import requests
4import base64
5
6'''
7文档去手写V2
8'''
9
10request_url = "https://aip.baidubce.com/rest/2.0/ocr/v1/remove_handwriting_v2"
11# 二进制方式打开图片文件
12f = open('[本地文件]', 'rb')
13img = base64.b64encode(f.read())
14
15params = {
16 "image": img,
17 "enable_detect": "true", # true:去除文件边缘后再识别(默认,适用于有背景/边缘的拍摄件);false:不去除(适用于扫描件)
18 "enable_ori": 0, # 0:不转正(默认);1:开启方向转正
19}
20access_token = '[调用鉴权接口获取的token]'
21request_url = request_url + "?access_token=" + access_token
22headers = {'content-type': 'application/x-www-form-urlencoded'}
23response = requests.post(request_url, data=params, headers=headers)
24if response:
25 print(response.json())1package com.baidu.ai.aip;
2
3import com.baidu.ai.aip.utils.Base64Util;
4import com.baidu.ai.aip.utils.FileUtil;
5import com.baidu.ai.aip.utils.HttpUtil;
6
7import java.net.URLEncoder;
8
9/**
10* 文档去手写V2
11*/
12public class RemoveHandwritingV2 {
13
14 /**
15 * 重要提示代码中所需工具类
16 * FileUtil,Base64Util,HttpUtil,GsonUtils请从
17 * https://ai.baidu.com/file/658A35ABAB2D404FBF903F64D47C1F72
18 * https://ai.baidu.com/file/C8D81F3301E24D2892968F09AE1AD6E2
19 * https://ai.baidu.com/file/544D677F5D4E4F17B4122FBD60DB82B3
20 * https://ai.baidu.com/file/470B3ACCA3FE43788B5A963BF0B625F3
21 * 下载
22 */
23 public static String removeHandwritingV2() {
24 // 请求url
25 String url = "https://aip.baidubce.com/rest/2.0/ocr/v1/remove_handwriting_v2";
26 try {
27 // 本地文件路径
28 String filePath = "[本地文件路径]";
29 byte[] imgData = FileUtil.readFileByBytes(filePath);
30 String imgStr = Base64Util.encode(imgData);
31 String imgParam = URLEncoder.encode(imgStr, "UTF-8");
32
33 // enable_detect: true=去除文件边缘后再识别(默认,适用于拍摄件);false=不去除(适用于扫描件)
34 // enable_ori: 0=不转正(默认);1=开启方向转正
35 String param = "image=" + imgParam
36 + "&enable_detect=true"
37 + "&enable_ori=0";
38
39 // 注意这里仅为了简化编码每一次请求都去获取access_token,线上环境access_token有过期时间, 客户端可自行缓存,过期后重新获取。
40 String accessToken = "[调用鉴权接口获取的token]";
41
42 String result = HttpUtil.post(url, accessToken, param);
43 System.out.println(result);
44 return result;
45 } catch (Exception e) {
46 e.printStackTrace();
47 }
48 return null;
49 }
50
51 public static void main(String[] args) {
52 RemoveHandwritingV2.removeHandwritingV2();
53 }
54}1#include <iostream>
2#include <curl/curl.h>
3
4// libcurl库下载链接:https://curl.haxx.se/download.html
5// jsoncpp库下载链接:https://github.com/open-source-parsers/jsoncpp/
6const static std::string request_url = "https://aip.baidubce.com/rest/2.0/ocr/v1/remove_handwriting_v2";
7static std::string remove_handwriting_v2_result;
8/**
9* curl发送http请求调用的回调函数,回调函数中对返回的json格式的body进行了解析,解析结果储存在全局的静态变量当中
10* @param 参数定义见libcurl文档
11* @return 返回值定义见libcurl文档
12*/
13static size_t callback(void *ptr, size_t size, size_t nmemb, void *stream) {
14 // 获取到的body存放在ptr中,先将其转换为string格式
15 remove_handwriting_v2_result = std::string((char *) ptr, size * nmemb);
16 return size * nmemb;
17}
18/**
19* 文档去手写V2
20* enable_detect: true=去除文件边缘后再识别(默认,适用于拍摄件);false=不去除(适用于扫描件)
21* enable_ori: 0=不转正(默认);1=开启方向转正
22* @return 调用成功返回0,发生错误返回其他错误码
23*/
24int removeHandwritingV2(std::string &json_result, const std::string &access_token) {
25 std::string url = request_url + "?access_token=" + access_token;
26 CURL *curl = NULL;
27 CURLcode result_code;
28 int is_success;
29 curl = curl_easy_init();
30 if (curl) {
31 curl_easy_setopt(curl, CURLOPT_URL, url.data());
32 curl_easy_setopt(curl, CURLOPT_POST, 1);
33 curl_httppost *post = NULL;
34 curl_httppost *last = NULL;
35 curl_formadd(&post, &last, CURLFORM_COPYNAME, "image", CURLFORM_COPYCONTENTS, "【base64_img】", CURLFORM_END);
36 curl_formadd(&post, &last, CURLFORM_COPYNAME, "enable_detect", CURLFORM_COPYCONTENTS, "true", CURLFORM_END);
37 curl_formadd(&post, &last, CURLFORM_COPYNAME, "enable_ori", CURLFORM_COPYCONTENTS, "0", CURLFORM_END);
38
39 curl_easy_setopt(curl, CURLOPT_HTTPPOST, post);
40 curl_easy_setopt(curl, CURLOPT_WRITEFUNCTION, callback);
41 result_code = curl_easy_perform(curl);
42 if (result_code != CURLE_OK) {
43 fprintf(stderr, "curl_easy_perform() failed: %s\n",
44 curl_easy_strerror(result_code));
45 is_success = 1;
46 return is_success;
47 }
48 json_result = remove_handwriting_v2_result;
49 curl_easy_cleanup(curl);
50 is_success = 0;
51 } else {
52 fprintf(stderr, "curl_easy_init() failed.");
53 is_success = 1;
54 }
55 return is_success;
56}1<?php
2/**
3* 发起http post请求(REST API), 并获取REST请求的结果
4* @param string $url
5* @param string $param
6* @return - http response body if succeeds, else false.
7*/
8function request_post($url = '', $param = '')
9{
10 if (empty($url) || empty($param)) {
11 return false;
12 }
13
14 $postUrl = $url;
15 $curlPost = $param;
16 // 初始化curl
17 $curl = curl_init();
18 curl_setopt($curl, CURLOPT_URL, $postUrl);
19 curl_setopt($curl, CURLOPT_HEADER, 0);
20 // 要求结果为字符串且输出到屏幕上
21 curl_setopt($curl, CURLOPT_RETURNTRANSFER, 1);
22 curl_setopt($curl, CURLOPT_SSL_VERIFYPEER, false);
23 // post提交方式
24 curl_setopt($curl, CURLOPT_POST, 1);
25 curl_setopt($curl, CURLOPT_POSTFIELDS, $curlPost);
26 // 运行curl
27 $data = curl_exec($curl);
28 curl_close($curl);
29
30 return $data;
31}
32
33$token = '[调用鉴权接口获取的token]';
34$url = 'https://aip.baidubce.com/rest/2.0/ocr/v1/remove_handwriting_v2?access_token=' . $token;
35$img = file_get_contents('[本地文件路径]');
36$img = base64_encode($img);
37$bodys = array(
38 'image' => $img,
39 'enable_detect' => 'true', // true:去除文件边缘后再识别(默认,适用于拍摄件);false:不去除(适用于扫描件)
40 'enable_ori' => 0, // 0:不转正(默认);1:开启方向转正
41);
42$res = request_post($url, $bodys);
43
44var_dump($res);1using System;
2using System.IO;
3using System.Net;
4using System.Text;
5using System.Web;
6
7namespace com.baidu.ai
8{
9 public class RemoveHandwritingV2
10 {
11 // 文档去手写V2
12 public static string removeHandwritingV2()
13 {
14 string token = "[调用鉴权接口获取的token]";
15 string host = "https://aip.baidubce.com/rest/2.0/ocr/v1/remove_handwriting_v2?access_token=" + token;
16 Encoding encoding = Encoding.Default;
17 HttpWebRequest request = (HttpWebRequest)WebRequest.Create(host);
18 request.Method = "post";
19 request.KeepAlive = true;
20 // 图片的base64编码
21 string base64 = getFileBase64("[本地图片文件]");
22 // enable_detect: true=去除文件边缘后再识别(默认,适用于拍摄件);false=不去除(适用于扫描件)
23 // enable_ori: 0=不转正(默认);1=开启方向转正
24 String str = "image=" + HttpUtility.UrlEncode(base64)
25 + "&enable_detect=true"
26 + "&enable_ori=0";
27 byte[] buffer = encoding.GetBytes(str);
28 request.ContentLength = buffer.Length;
29 request.GetRequestStream().Write(buffer, 0, buffer.Length);
30 HttpWebResponse response = (HttpWebResponse)request.GetResponse();
31 StreamReader reader = new StreamReader(response.GetResponseStream(), Encoding.Default);
32 string result = reader.ReadToEnd();
33 Console.WriteLine("文档去手写V2:");
34 Console.WriteLine(result);
35 return result;
36 }
37
38 public static String getFileBase64(String fileName) {
39 FileStream filestream = new FileStream(fileName, FileMode.Open);
40 byte[] arr = new byte[filestream.Length];
41 filestream.Read(arr, 0, (int)filestream.Length);
42 string baser64 = Convert.ToBase64String(arr);
43 filestream.Close();
44 return baser64;
45 }
46 }
47}返回说明
返回参数
| 参数 | 类型 | 是否必须 | 说明 |
|---|---|---|---|
| log_id | uint64 | 是 | 唯一的log id,用于问题定位 |
| image_processed | string | 是 | 返回处理后的图片,base64编码 |
| pdf_file_size | string | 否 | 传入PDF文件的总页数,当 pdf_file 参数有效时返回该字段 |
返回示例
JSON
1{
2    "image_processed": "/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAAYEBQYFB",
3    "log_id": 1540571996316633631
4}
评价此篇文章