

千人千面最佳实践
一、功能介绍
1.1. 什么是千人千面
千人千面使同一个智能体具备区分不同用户的能力,并结合当前交流对象的人物信息、习惯与偏好,提供个性化的交流体验。例如,小明和小红共用一个智能设备,智能体可以认出他们,并在两人询问“今晚吃什么”时,根据各自的饮食偏好给出不同建议。
1.2 千人千面包含哪些能力
千人千面包括人物注册、人物识别、个人画像和注销人物注册四项能力:
| 能力 | 做什么 | 对交流的帮助 | 使用示例 |
|---|---|---|---|
| 人物注册 | 登记姓名,并同时采集对应的人脸和声纹 | 让智能体以后能认出这个人 | 使用者说“记住我,我叫小明”,按提示面向摄像头并说话,完成注册 |
| 人物识别 | 同时通过人脸和声纹区分已注册的人物,获取注册时填写的姓名 | 让智能体知道正在和谁交流,并使用对应称呼 | 小明面向摄像头说话,智能体认出小明,并称呼他“小明” |
| 个人画像 | 从交流中逐步积累每个人的习惯与偏好,并用于回答 | 根据不同人的特点提供建议 | 同样询问晚餐建议,为偏好清淡的小明推荐清蒸鱼,为喜欢麻辣的小红推荐麻婆豆腐 |
| 注销人物注册 | 删除注册时保存的姓名、人脸和声纹信息 | 让用户撤销注册,系统不再通过这些信息识别该人物 | 小明注销注册后,需要重新注册才能再次被认出 |
当前人物注册和人物识别仅支持人脸与声纹共同参与,需要同时提供摄像头画面和麦克风声音。姓名在注册时登记,习惯与偏好随着交流逐步形成。注销人物注册不会同时删除该人物的画像。
二、快速接入
步骤总览
准备具备摄像头和麦克风的设备,并确保客户端能够正常上传画面和声音。
- 开启功能:创建智能体,配置千人千面、人脸与声纹能力、视频上传及语音识别扩展信息。
- 注册人物:通过语音或客户端消息发起注册,提供姓名,按提示面向摄像头并说话,等待注册结果。
- 正常对话:系统同时通过人脸和声纹识别已注册人物。
- 使用画像:系统从交流中异步积累画像,并使用实例已加载的画像提供个性化回复。
已注册人物再次使用时,无需重复注册,开启能力后即可正常对话。
2.1 创建智能体并开启功能
2.1.1 接口
1POST /api/v1/aiagent/generateAIAgentCall
2Host: rtc-aiagent.baidubce.com鉴权、完整请求参数和响应说明见《创建大模型互动实例》。
2.1.2 关键请求参数
在已有可正常进行音视频对话的实例配置上,补充以下参数。完整API内容见《服务端 API》,本场景取值单独列出。
请求体
| 名称 | 类型 | 本场景是否必填 | 描述 | 注意事项及示例值 |
|---|---|---|---|---|
app_id |
String | 是 | 大模型互动应用ID | |
config.user_id |
String | 是 | 应用设定的唯一user_id,用于标识不同用户,要求appid应用级别内唯一,建议使用手机号码或设备串号等 | 例:enterprise-1-toy-0000001 |
config.human.enable_personalization |
Boolean | 是 | 千人千面开关,开启后会根据声纹和人脸识别结果生成人物专属画像 | |
config.human.sense.visual.enable |
Boolean | 是 | 开启视觉理解 | |
config.visual.up.format |
String | 是 | 视觉格式支持 【h264, picture/picture2, movjpeg/movjpeg2 】h264 标识传输内容H264 picture/picture2 标识传输内容图片, rtos设备使用picture, 其他设备使用picture2 movjpeg/movjpeg2 标识传输内容图片流,rtos设备使用movjpeg, 其他设备使用movjpeg2 |
本场景使用 h264。 |
config.enable_asr_ext |
bool | 是 | ASR信息扩展,支持携带附加信息(情绪、声纹信息)。 打开身份识别 identity_recognition.enable 支持ASR通过扩展携带说话人信息, 详见《声纹最佳实践》 |
|
config.identity_recognition.enable |
Boolean | 是 | 识别身份开关 | true 打开身份识别功能,并且打开声纹识别false 关闭身份识别功能 |
config.identity_recognition.voice_similarity |
Number[] | 是 | 声纹匹配阈值 | 例:[0.24,0.30,0.34,0.42] |
config.identity_recognition.face_enable |
Boolean | 是 | 人脸注册与识别开关 | |
config.identity_recognition.face_similarity |
Number | 是 | 人脸匹配阈值 | 例: 0.45 |
config.user_id 标识本例中的设备;人物标识用于区分同一设备上注册的不同人,两者不是同一个标识。
当前版本要求人脸识别与声纹识别同时启用,需将 config.identity_recognition.enable 与 config.identity_recognition.face_enable 均设为 true,并同时上传图像与音频数据。暂不支持仅启用单一识别方式(仅声纹或仅人脸)接入。
2.1.3 请求示例
替换应用 ID 和设备标识,并合并已有音视频对话配置后发送。config 是 JSON 对象序列化后的字符串。
1{
2  "app_id": "yourAppId",
3  "config": "{\"user_id\":\"yourDeviceId\",\"human\":{\"enable_personalization\":true,\"sense\":{\"visual\":{\"enable\":true}}},\"identity_recognition\":{\"enable\":true,\"voice_similarity\":[0.24,0.30,0.34,0.42],\"face_enable\":true,\"face_similarity\":0.45},\"visual\":{\"up\":{\"format\":\"h264\"}},\"enable_asr_ext\":true}"
4}声纹阈值含义及配置参考《声纹使用最佳实践》。
2.2 人物注册、查询与注销
可以通过语音触发函数调用(Function Call,简称 FC),也可以在客户端通过 SDK 发送对应消息。
开启声纹和人脸识别开关后,开启注册人物、查询人物、注销人物FC配置;SDK 方式由接入方触发注册、查询、删除等指令。
2.2.1 注册人物
注册支持以下两种方式,操作时需注意以下事项:
- 请让脸部正对镜头,五官清晰可见
- 请勿遮挡额头、眼睛、鼻子和嘴巴
- 保持环境光线充足,避免逆光或过暗,避免强光直射脸部导致过曝
- 请勿佩戴口罩、墨镜或帽子
- 脸部与镜头保持约30-50厘米距离
- 注册过程中请保持不动,避免晃动
- 请选择安静环境,减少背景噪音,请勿在嘈杂的公共场所进行注册,关闭周围的音乐、电视等声音干扰源
- 注册时请用正常语速说话,不要过快或过慢
- 避免多人同时说话,确保只有您的声音
方式一:语音触发
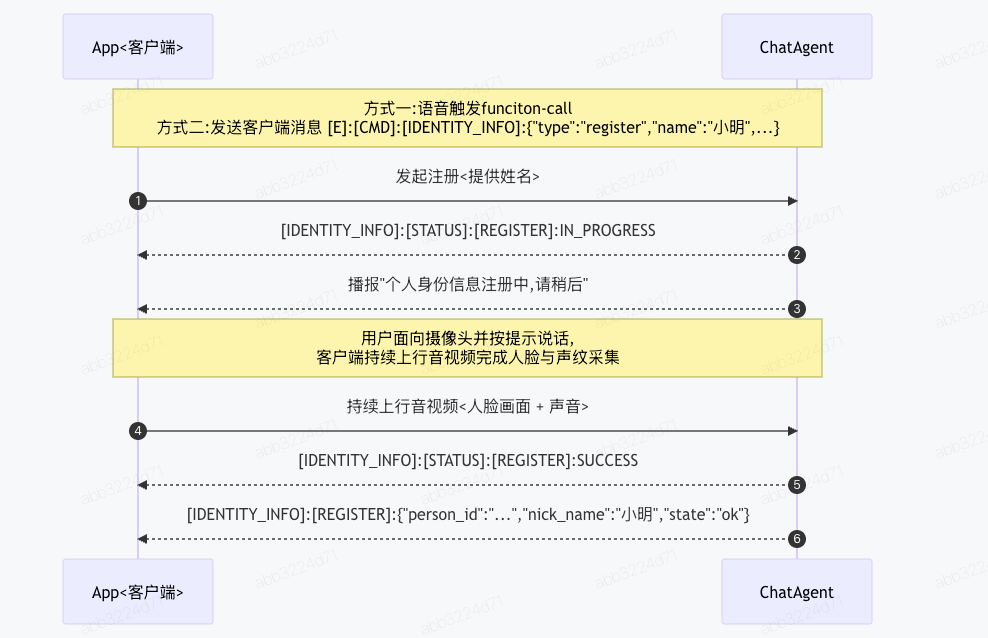
研发人员完成注册 FC 配置后,用户可通过语音说出"记住我,我叫小明" 触发注册。用户按提示面向摄像头并说话,客户端持续上传画面和声音。系统完成姓名登记、人脸和声纹采集后反馈结果;只有收到注册成功结果,才表示注册完成。
同时容许以下触发短语触发注册: 记住这个人、记住那个人、把我记住、把他记住、认识一下、注册人脸、登记信息、录入人脸、添加人脸信息。
方式二:SDK 消息触发
客户端可以提供“注册”按钮和姓名输入框。用户填写姓名后,通过 SDK 发送:
1[E]:[CMD]:[IDENTITY_INFO]:{"type":"register","name":"小明","succ_tip":"好的,已经记住你了。","fail_tip":"注册失败,请重试。"}name 为注册姓名,succ_tip 和 fail_tip 分别设置成功、失败时的播报内容。发送后同样需要持续上传画面和声音。客户端可根据以下关键消息显示进度和结果:
语音触发和SDK消息触发注册任务,都会有注册状态返回,以下消息是服务器端返回注册状态消息。
| 消息内容 | 含义 | 例子 |
|---|---|---|
[E]:[IDENTITY_INFO]:[STATUS]:[REGISTER]:IN_PROGRESS |
注册中 | |
[E]:[IDENTITY_INFO]:[STATUS]:[REGISTER]:SUCCESS |
注册成功 | |
[E]:[IDENTITY_INFO]:[STATUS]:[REGISTER]:FAILED |
注册失败 | |
[E]:[IDENTITY_INFO]:[REGISTER]:{...} |
注册结果信息 | [E]:[IDENTITY_INFO]:[REGISTER]:{ "nick_name": "张三", "state": "ok", "person_id": "3cxXcQ2atvXBsM8gx30Unf"} |
2.2.2 查询人物信息
方式一:语音查询当前人物
研发人员完成查询 FC 配置后,已注册用户可面向摄像头说出"你认识我吗"或"我叫什么名字"。系统结合人脸和声纹识别人物,识别成功后可回答注册时填写的姓名。这是主动查询身份的用法,正常对话不需要每次先问一次。
同时容许以下触发短语触发查询: 我是谁、我是谁呀、我是谁啊、认识我吗、认得我吗、认一下我、认识一下我、认识他吗、认得他吗、你认识他吗、我叫什么、我叫啥、我的名字是什么、看看我是谁、你看看我是谁、看一下我是谁、这个人是谁、那个人是谁、他是谁、这些人都是谁、记得我吗、还记得我吗。
方式二:SDK 查询
客户端可展示已注册人物列表,供用户核对注册信息。需注意:查询列表与识别当前说话人是两个独立操作,列表中的人物不代表当前正在交流的对象。
| 消息内容 | 含义 | 例子 |
|---|---|---|
[E]:[CMD]:[IDENTITY_INFO]:{"type":"list"} |
查询已注册人物列表 | [E]:[IDENTITY_INFO]:[LIST]:{ "data": { "count": 1, "users": [ { "created_at": "2026-09-09T11:12:39.150000+08:00", "display_name": "二蛋", "person_id": "5MlJjHMyhePxcev7vCIKWM" } ] }, "success": true, "trans_id": "FagYHgHVEO"} |
2.2.3 注销人物信息
方式一:语音触发
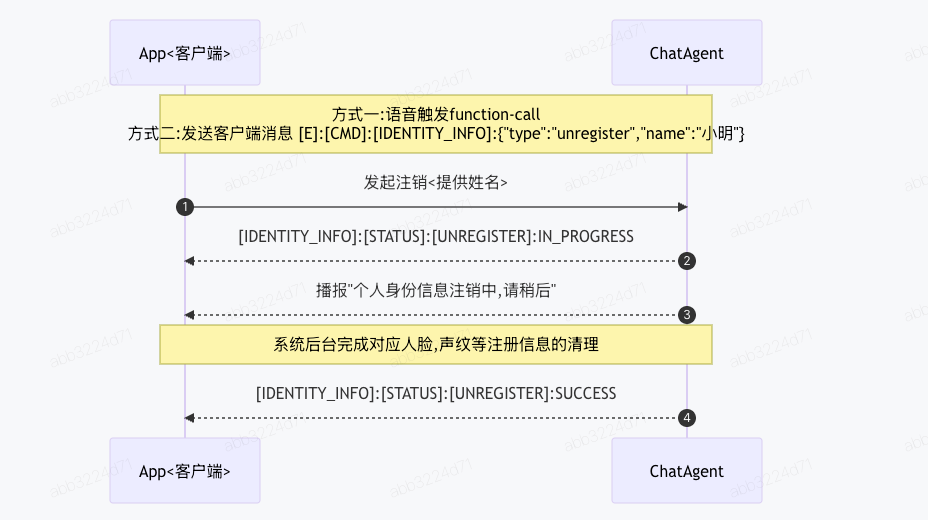
研发人员完成删除 FC 配置后,用户可通过语音说出"删除我的注册信息,我叫小明"触发注销;系统删除对应的注册姓名、人脸及声纹信息后,反馈注销结果。
同时容许以下触发短语触发注销: 删除人脸、删除我的脸、删除我的人脸、帮我删除人脸、移除人脸、移除我的脸、刷脸移除、取消人脸、删掉人脸、删掉我的脸、注销人脸、清除人脸、把我忘掉、别记住我了。
方式二:SDK 消息触发
客户端在用户选择注销对象并确认后发送:
1[E]:[CMD]:[IDENTITY_INFO]:{"type":"unregister","name":"小明","succ_tip":"好的,已删除注册信息。","fail_tip":"注销失败,请重试。"}语音触发和SDK消息触发注销,都会有注销状态返回,以下消息是服务器端返回注销状态消息。
| 消息内容 | 含义 |
|---|---|
[E]:[IDENTITY_INFO]:[STATUS]:[UNREGISTER]:IN_PROGRESS |
注销中 |
[E]:[IDENTITY_INFO]:[STATUS]:[UNREGISTER]:SUCCESS |
注销成功 |
[E]:[IDENTITY_INFO]:[STATUS]:[UNREGISTER]:FAILED |
注销失败 |
注销后,需要重新注册才能再次被认出。注销人物注册不会同时删除画像。
2.3 正常对话并识别人物
注册成功后,用户面向摄像头正常说话,系统同时通过人脸和声纹识别当前人物,并用人物标识关联对应的个人画像,无需每轮重新注册或询问“我是谁”。
如果业务界面需要展示当前说话人的姓名,可接收语音识别(ASR)结果中的扩展信息。
| SDK | 接口名称 | 链接 |
|---|---|---|
| Android SDK | void onUserAsrSubtitle(String text, boolean isFinal, Constants.ASRExtInfo info)info 包含识别身份信息 |
链接 |
| iOS SDK | - (void) onUserAsrSubtitle:(NSString* )text isFinal:(BOOL)isFinal ext:(AgentAsrExtInfo *)info;info 包含识别身份信息 |
链接 |
| RTOS SDK | void (onUserAsrSubtitle)(const char* text, size_t text_len, bool final, const ASRExtInfo* info);info 包含识别身份信息 |
链接 |
| WebSocket/H5/Linux SDK | [Q]:北京欢迎你。|||[name]:小明&[emotion]:高兴&[score]:45 name 标记身份信息 |
链接 |
2.4 通过对话积累和使用个人画像
系统根据当前交流对象的人物标识,自动积累和使用对应的个人画像。
通过交流积累画像
人物注册建立了人物标识,习惯与偏好则需要通过后续交流逐步形成。例如,小明和小红分别完成注册,并在系统分别认出两人后交流:
小明:我平时喜欢吃清淡一点,尽量少辣。 小红:我喜欢川菜,尤其喜欢麻辣口味。 系统在后台异步提炼这些习惯与偏好,分别更新两人的个人画像,一般需要约一分钟。
在回答中使用画像
系统在实例启动时加载画像。交流中新生成或更新的画像,会在实例下次启动时刷新并用于回答。
后续对话中,系统根据当前人物标识选择可用画像,并将画像与当前问题、历史对话一起提供给模型,作为生成回复的参考:
1用户提出问题
2  → 同时通过人脸和声纹识别当前人物,获得人物标识
3  → 根据人物标识选择个人画像
4  → 将画像与当前问题、历史对话一起提供给模型
5  → 生成个性化回复
当两人的画像已生成并加载后,分别询问“今晚吃什么”,可以获得不同的建议:
| 当前人物 | 可用画像 | 回复示例 |
|---|---|---|
| 小明 | 饮食偏清淡、少辣 | 可以考虑清蒸鱼配蔬菜。 |
| 小红 | 喜欢川菜、麻辣口味 | 可以考虑麻婆豆腐配米饭。 |
三、画像管理
3.1 设备默认画像与个人画像
画像用于记录交流中了解到的用户习惯与偏好,分为两类:
- 设备默认画像:保存在设备下、未归属到具体人物的习惯与偏好。用户尚未注册,或对话时未被识别出来,系统可能将交流中提炼的信息记录在这里。
- 个人画像:属于某个已注册人物的习惯与偏好。系统识别到人物后,会从后续交流中逐步积累该人物的画像。
回答时,系统结合个人画像和设备默认画像提供建议,优先使用个人画像。例如,设备默认画像记录“饮食偏清淡”,小红的个人画像记录“喜欢麻辣”,与小红交流时优先参考她的口味。
3.2 查看和修改画像
如需查看系统记录了哪些习惯与偏好,或修改、删除其中的内容,可使用画像管理 HTTP API。接口支持画像查询、写入、按维度删除及画像内容清空,以及画像维度(category)的查询、添加、移除和清空。参数与调用示例见《记忆管理 API》。
目前画像管理 API 仅支持设备级画像的查询、写入、删除及清空;讲话者级画像管理能力正在开发中,暂未开放。
四、常见疑问
4.1 开启千人千面后,就能直接认出用户吗?
不能。用户需先完成人物注册,注册完成后正常说话(面向摄像头),系统才会结合人脸与声纹完成身份识别。
4.2 千人千面需要同时开启拟人化记忆吗?
不需要。两项能力可独立开启,都会保留当前问题和历史对话,额外提供给模型的信息如下:
| 开启方式 | 额外提供的信息 |
|---|---|
| 仅千人千面 | 当前人物的个人画像与设备默认画像,不检索历史记忆 |
| 仅拟人化记忆 | 设备默认画像和相关记忆,不按人物区分 |
| 同时开启 | 当前人物的个人画像与设备默认画像,以及从该人物和设备默认记忆中检索的相关内容 |
4.3 人物注册、注销的完整流程是怎么样的?
人物注册时序图
人物注销时序图
评价此篇文章