

健康检查概述
什么是健康检查
负载均衡 BLB 通过健康检查来判断后端服务器的可用性。开启健康检查后,BLB 会周期性地向后端服务器发送探测请求:
- 当某台后端服务器被判定为 异常(unhealthy)时,BLB 会将其从服务器池中摘除,新的客户端请求不再转发到该服务器;
- 当该服务器恢复正常并被重新判定为 健康(healthy)时,BLB 会自动将其重新加入服务器池,恢复流量转发。
健康检查机制可以在部分后端服务器故障时自动隔离异常节点,将流量调度到正常节点上,从而提升业务整体可用性,避免局部故障影响整体服务。
为保障业务持续可用,不建议关闭健康检查。若业务对负载较为敏感,可通过增大检查间隔、调整阈值、或将七层检查改为四层检查等方式降低健康检查对业务的影响。
健康检查工作原理
BLB 采用集群化部署,集群节点同时负责流量转发与健康检查。健康检查按照配置的间隔时间周期性发起探测,并依据响应超时时间与健康 / 不健康阈值综合判定后端状态:
- 后端服务器连续健康检查成功次数达到「健康阈值」后,判定为健康,重新加入服务器池;
- 后端服务器连续健康检查失败次数达到「不健康阈值」后,判定为异常,从服务器池摘除。
引入阈值的目的是避免因偶发抖动导致后端状态频繁切换,只有在连续多次成功或失败后才会切换状态。
健康检查协议与机制
不同监听/后端协议对应的健康检查方式如下。各协议均需在「响应超时时间」窗口内收到预期响应才判定为健康,超时未响应即计为一次失败。
TCP 健康检查
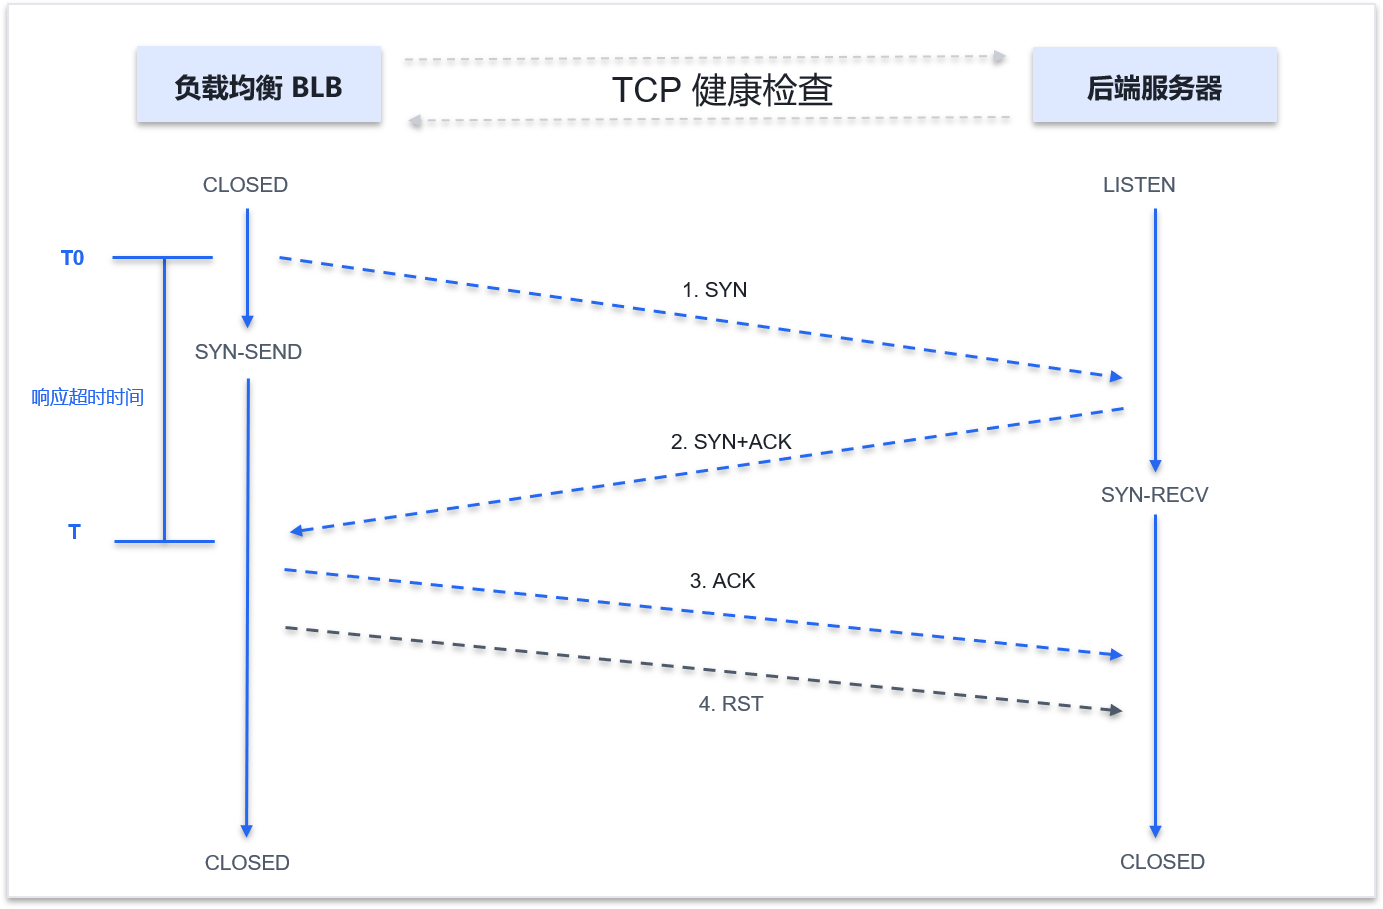
四层 TCP 监听通过 TCP 探测获取后端状态:
- 集群节点按健康检查配置向后端服务器的内网 IP + 健康检查端口发送 TCP SYN 报文。
- 若后端相应端口正常监听,返回 SYN+ACK 报文。
- 若在【响应超时时间】内,BLB收到了后端返回的SYN+ACK报文,则认为服务正常运行,判定健康检查成功。BLB将进一步发送ACK数据包,随后立即发送RST数据包中断TCP连接。
- 若在【响应超时时间】内,BLB未收到后端返回报文,判定健康检查失败,并向后端服务器发送RST数据包中断TCP连接。
TCP 探测可能使后端服务器记录到异常 TCP 连接,在业务日志中出现
Connection reset by peer等信息。可通过改用 HTTP 方式健康检查,或在后端忽略来自 BLB 服务地址段的连接错误来规避。
UDP 健康检查
四层 UDP 监听/目标组支持 UDP、ICMP、ICMP_UDP 三种健康检查方式,三者的探测与判定逻辑对比如下:
| UDP 健康检查方式 | 探测发包 | 判定为健康的现象 | 判定为异常的现象 |
|---|---|---|---|
| UDP | 携带“检查请求字符串”的 UDP 报文 | 在响应超时时间内收到后端返回的 UDP 报文,不会校验UDP报文内容。 | 收到 ICMP port unreachable,或在超时时间内未收到 UDP 回包 |
| ICMP | ICMP echo | 在响应超时时间内收到 ICMP echo reply | 未收到 ICMP echo reply |
| ICMP_UDP | ICMP echo + 携带请求数据的 UDP 报文 | 收到 ICMP echo reply,且未收到 ICMP port unreachable | 收到 ICMP port unreachable,或未收到 ICMP echo reply |
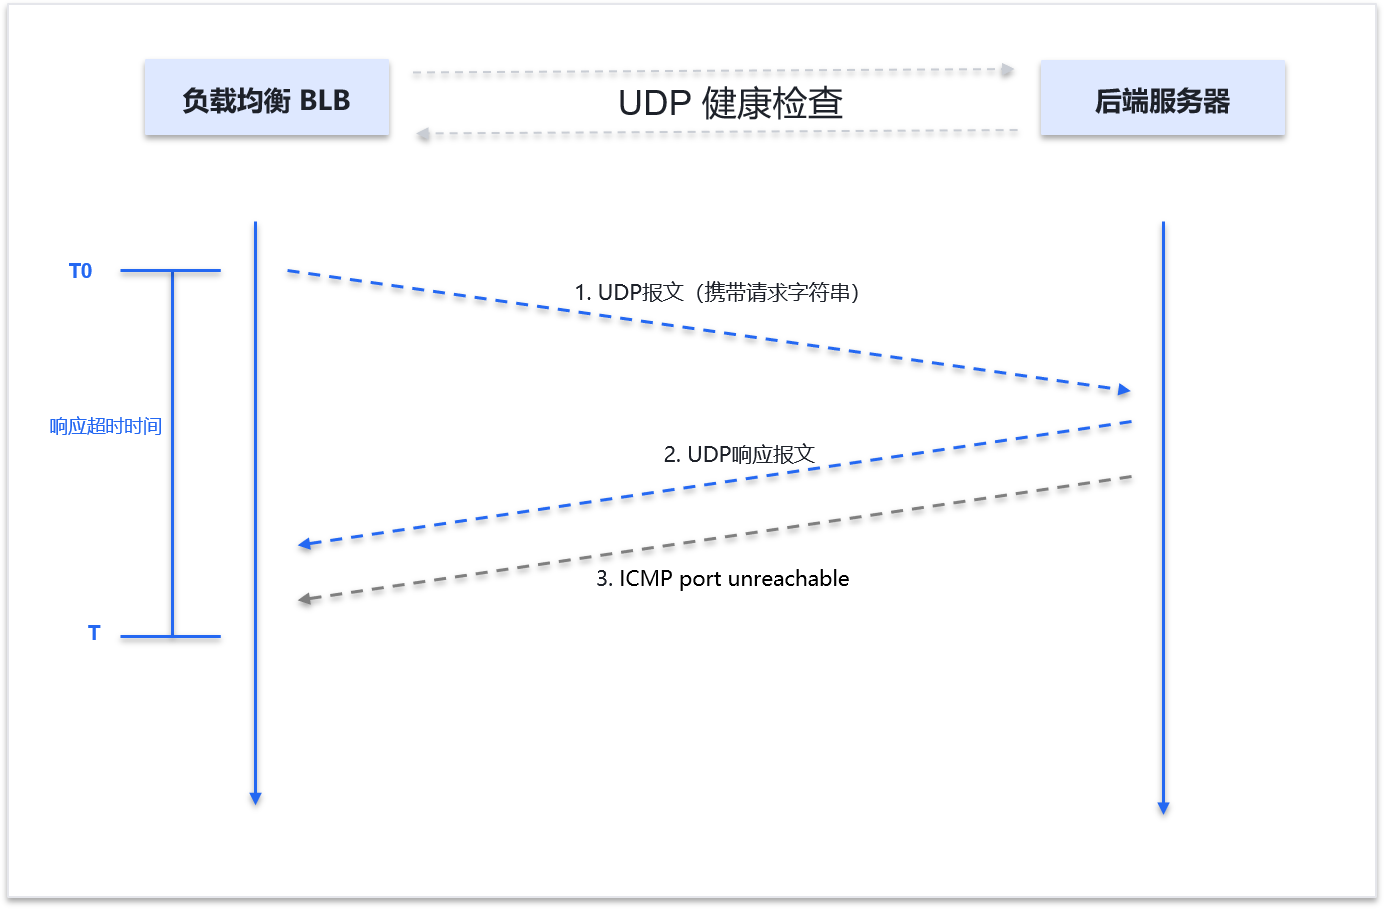
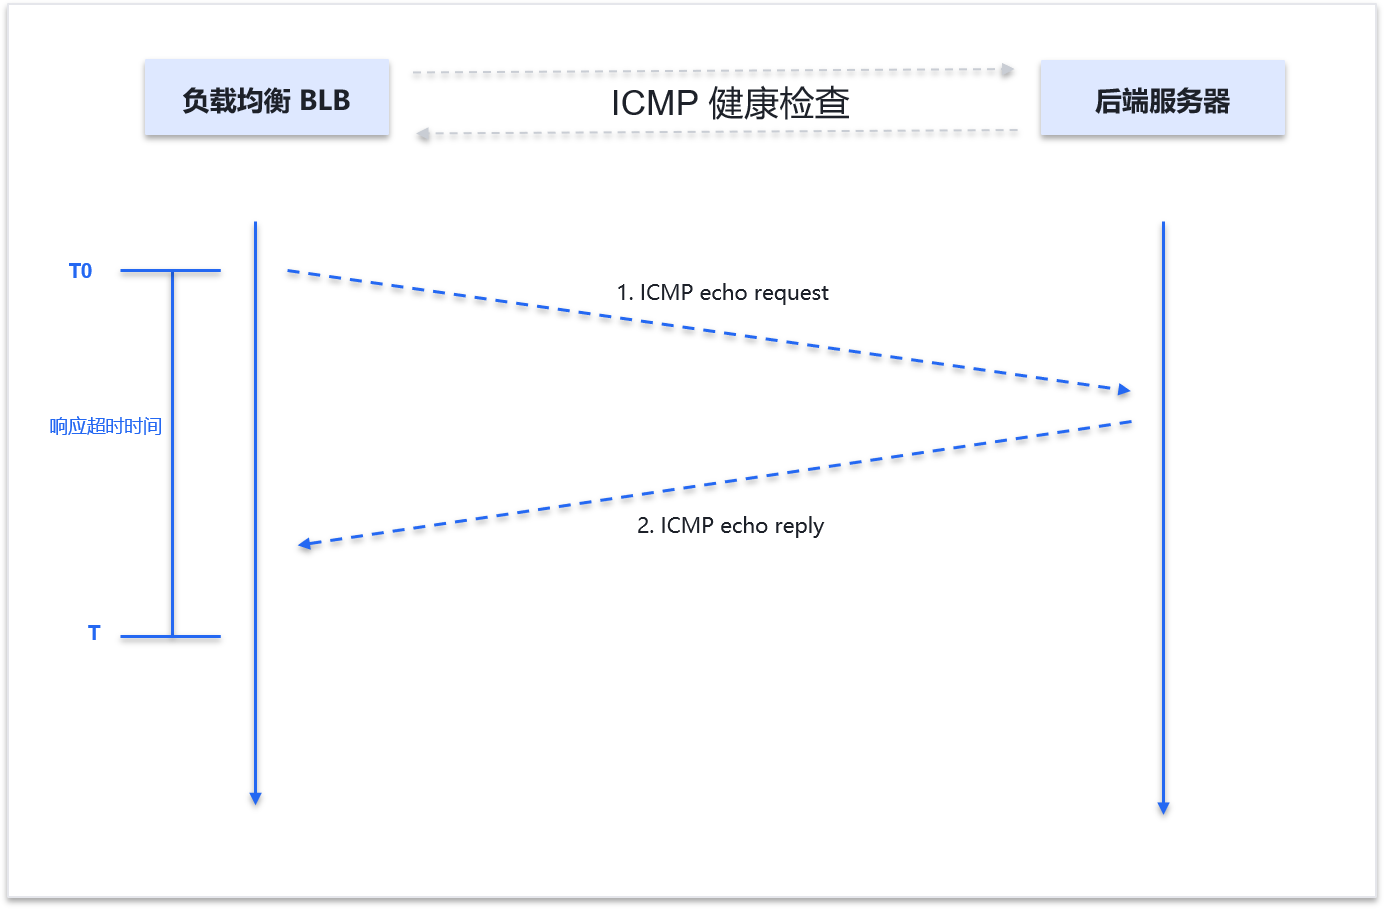
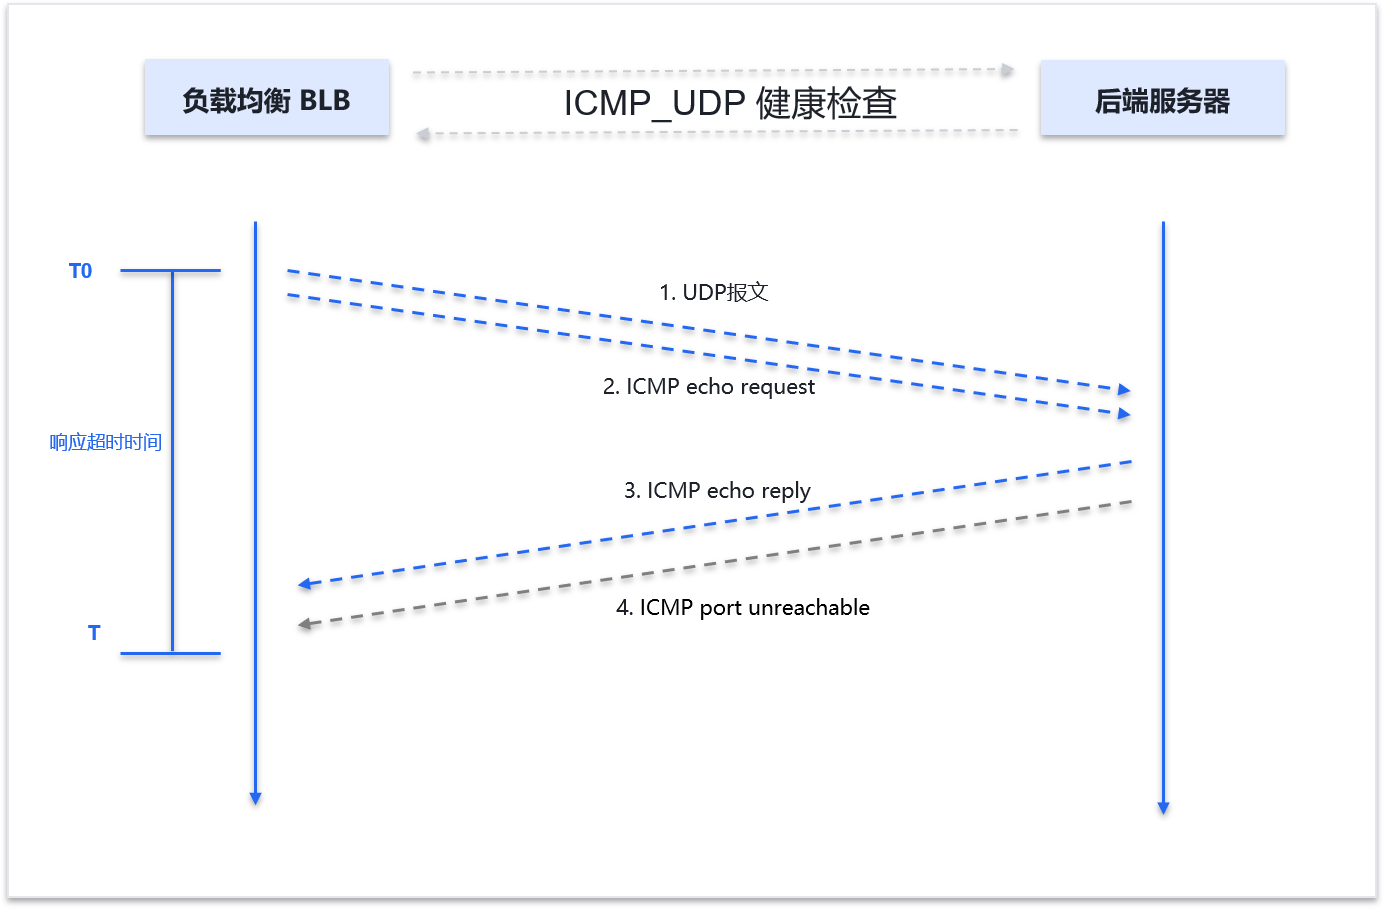
UDP 健康检查请求字符串
UDP 健康检查支持配置检查请求字符串,该字符串会作为 UDP 健康探测报文的有效载荷发送到后端服务器。
配置检查请求字符串有两种方法:
- 方法一:如果可以调整后端服务器上的应用程序。建议把检查字符串设置为类似于“hello”的简单字符串,然后调整应用程序来响应携带“hello”的UDP包。响应内容可以任意填写,BLB只要接受收到UDP响应包就认为健康检查正常。
- 方法二:如果不方便调整后端服务器上的应用程序,例如后端服务器上运行的是通用的DNS解析服务,这时可以配置一个正常服务请求用作健康检查。获取一个正常请求所对应的有效载荷: 可以通过tcpdump命令在后端服务器上抓取本机接收到的UDP包,或者在客户端机器上抓取本机发出的UDP包。
支持用户输入格式自定义探测内容,后端可以根据该内容返回 UDP 应答。
健康检查请求字符串配置规则如下:
- 支持直接填写 ASCII 字符;
- 支持使用反斜杠加两位十六进制数表示一个字节,例如
\00、\0A; - 最大长度为 512 字节;转义序列按其实际字节数计算,超过长度的内容会被截断;
- 检查请求字符串是可修改的配置项,不是不可变的固定值;
- 用户未主动配置时,控制台默认预填一个标准 DNS 查询报文作为默认值。
100010100000100000000000005baidu03com0000010001该默认值表示对 baidu.com 的 A 记录 DNS 查询,是一个二进制 DNS 请求报文的十六进制表示,并不代表 UDP 健康检查只能检查 DNS 服务。
支持用户将其替换为业务自定义字符串,例如 hello、smoketest 或其他后端能够识别的请求内容。
重要:BLB 不校验 UDP 回包内容。 对普通 UDP 健康检查,BLB 主要依据是否在响应超时时间内收到后端返回的 UDP 报文进行判定,不会校验回包是否与请求字符串对应,也不会解析回包中的业务字段。因此,如果希望检查结果能够反映具体业务处理能力,需要由后端服务根据请求字符串执行校验,并在服务正常时返回 UDP 应答;仅发送探测包而不返回 UDP 回包,不能满足普通 UDP 的成功判定条件。
ICMP_UDP 健康检查配置说明
增强型 UDP(ICMP_UDP)同样支持携带请求数据进行 UDP 探测,但其请求数据可能使用增强型 UDP 对应的请求数据配置项,而不是普通 UDP 健康检查页面中的同名字段。
增强型 UDP (ICMP_UDP)的最终成功条件仍然是:在响应超时时间内收到 ICMP echo reply,且未收到 ICMP port unreachable。UDP 回包内容不作为独立的业务内容匹配条件。
增强型 UDP(ICMP_UDP) 结合了 ICMP 连通性探测与 UDP 端口探测:BLB 同时向后端发送 ICMP echo 请求与 UDP 探测报文,等待响应超时时间窗口结束后,仅当「收到 ICMP echo reply 且未收到 ICMP port unreachable」时才判定为健康。相比单独使用 UDP 或 ICMP,增强型 UDP 能更准确地反映后端服务的真实可用状态。
UDP 健康检查的一致性说明:UDP 为无连接协议,在大并发场景下,若后端为 Linux 服务器,其防 ICMP 攻击保护机制会限制 ICMP 报文发送速率,可能导致后端服务已异常但未能及时返回
port unreachable,从而出现「服务真实状态与健康检查结果不一致」的情况。对于需要验证业务处理能力的场景,建议配置检查请求字符串,并由后端服务根据请求内容返回 UDP 应答;对于需要同时确认主机可达和端口状态的场景,可优先评估增强型 UDP。
HTTP 健康检查
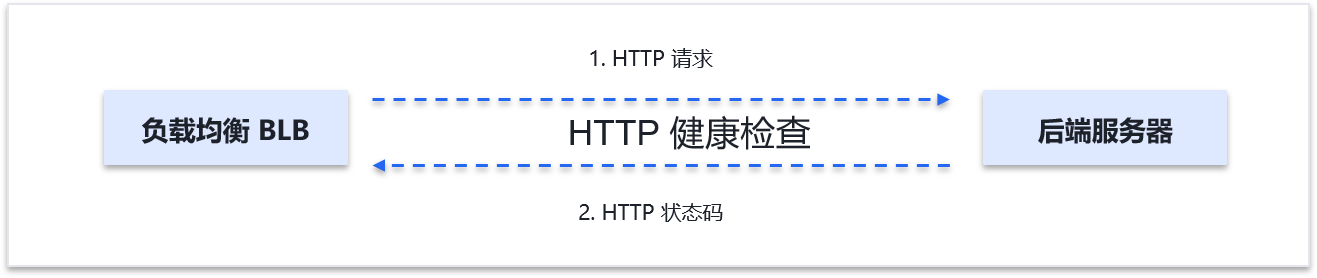
七层 HTTP / HTTPS 目标组支持通过 HTTP 请求进行健康检查:
- 集群节点按配置向后端发送 HTTP 请求(可配置检查路径与域名 Host);
- 后端返回 HTTP 状态码;
- 若在响应超时时间内未收到响应,判定失败;
- 若收到响应,则比对状态码,匹配健康状态码则判定成功,否则失败。
建议为健康检查配置专用检查路径(如
/health)并确保返回 2xx 状态码。使用 HTTP 方式检查时可配置域名 Host;若后端服务校验请求中的 Host 字段,请务必配置对应域名,否则健康检查请求可能被拒绝。
健康检查参数说明
在控制台配置监听或服务器组 / IP 组时,支持配置的健康检查参数如下:
| 参数 | 是否必填 | 取值范围 | 说明 |
|---|---|---|---|
| 检查请求字符串 / | 否 | ASCII 字符及\ 开头的两位十六进制转义字符;最大 512 字节 | 仅UDP和ICMP_UDP健康检查支持设置该参数。UDP健康检查将该内容作为 UDP 探测报文载荷。ICMP_UDP健康检查使用其对应的请求数据配置项。 |
|
| 健康检查协议版本 | 是 | HTTP 1.0 HTTP 1.1 |
HTTP健康检查的协议版本。 |
| 健康检查方法 | 是 | GET HEAD |
HTTP健康检查的检查方法。 |
| Host头域 | 否 | 由字母、数字及字符- _ / . % ? &组成,长度在0-80之间。 |
发往后端服务器的健康检查请求的Host头域,默认为空。 |
| 检查端口 | 否 | 1 ~ 65535 | 仅HTTP/HTTPS健康检查支持设置该参数。 健康检查使用的后端端口,不指定时使用监听的开放协议端口 |
| 响应超时时间 | 是 | 1 ~ 60,默认 3(秒) | 等待后端返回健康检查响应的最长时间,建议设置为 3 秒 |
| 健康检查间隔时间 | 是 | 1 ~ 10,默认 3(秒) | 两次健康检查之间的间隔;需满足「间隔时间 ≥ 响应超时时间」,以免 UDP 探测回包因超时被误判为未响应 |
| 不健康阈值 | 是 | 2 ~ 5 | 连续健康检查失败次数超过该阈值,后端被判定为异常并从服务器池摘除 |
| 健康阈值 | 是 | 2 ~ 5 | 连续健康检查成功次数超过该阈值,后端被判定为恢复正常并重新加入服务器池 |
| 正常状态码 | 是 | 支持选择 http_2xx、http_3xx、http_4xx、http_5xx | 仅HTTP健康检查支持设置该参数。 健康检查正常的http状态码。 |
健康检查时间窗
BLB 通过健康检查判断后端服务器是否可用。为避免网络抖动导致后端被频繁摘除、恢复,健康检查并非"一次失败就摘除",而是需要连续多次探测结果一致才切换状态。完成一次状态切换所需的时间,称为健康检查时间窗。
不健康判定时间窗
实际耗时取决于后端的故障表现,存在两种情况:
-
后端无响应(丢包、进程假死、网络不通):探测在超时时间内收不到任何回应。此时 BLB 会以「响应超时」为周期加速重试,直到失败次数达到不健康阈值。因此实际判定时间约为 响应超时 × 不健康阈值。
例:超时 3 秒、不健康阈值 3 次 → 约 9 秒判定异常
- 后端主动拒绝(端口未监听等场景下返回端口不可达、连接重置):这类响应会使判定更快推进,实际判定时间通常只有一两个探测周期。
恢复健康时间窗
后端恢复正常后,需要连续成功达到「健康阈值」次才重新加入。恢复时间约为 健康阈值 × 检查间隔。
例:间隔 3 秒、健康阈值 3 次 → 约 9 秒。
配置建议
- 【检查间隔】是稳态探测节奏,不是实际失败重试节奏。响应超时建议小于检查间隔,避免探测相互重叠造成误判。
- 新增后端服务器时,默认先为不可用状态,需通过健康检查后才承载流量。
- 若业务对故障摘除的及时性要求高,可适当调小响应超时与不健康阈值;若业务对抖动更敏感,则可增大阈值。
使用建议与注意事项
- 不建议关闭健康检查:对负载敏感的业务可通过增大检查间隔、调整阈值或改用四层检查来降低影响。
- 放行健康检查探测流量:请确保后端安全组、企业安全组、ACL 及后端主机 iptables 等策略放行监听端口与健康检查端口,否则会导致后端被误判为异常。
- UDP 请求字符串应与后端处理逻辑配套:如果只需要确认 UDP 端口能够接收报文,可使用简单探测字符串;如果需要验证业务处理能力,应让后端识别请求内容并在处理成功后返回 UDP 应答。
- 合理设置阈值与超时:阈值过小易因偶发抖动误摘后端,过大则故障切换变慢;建议您结合业务特点权衡。
- 源 IP 调度注意事项:当调度算法为源 IP 时,同一源 IP 的请求固定路由到同一后端;若后端同时作为客户端发起请求,可能出现「部分后端看似不健康」的假象,可改用轮询或最小连接算法规避。
评价此篇文章