

消费者纬度可观测
概述
消费者维度监控用于查看不同消费者访问 AI 网关时产生的 Token 用量使用情况。通过该页面,可以比较各消费者的资源消耗,识别用量较高的消费者,并进一步分析单个消费者使用的服务和模型。
前提条件
查看消费者维度监控前,请确认:
- 网关实例已经开启 Prometheus 监控服务,且关联的监控实例运行正常。
- 当前网关实例下至少存在一个消费者。
- 消费者已经授权给某个模型推理服务。
- 请求使用消费者对应的 API Key 访问 AI 服务。系统根据请求关联的消费者归集监控数据。
- 已经产生实际调用流量。新建消费者但尚未发送请求时,不会产生 Token 数据。
进入消费者监控页面
- 登录百度智能云控制台,进入 AI 原生网关。
- 选择需要查看的网关实例,进入实例详情。
- 在左侧导航中选择“监控与告警”。
- 设置需要查询的时间范围。
- 在“监控维度”中选择“消费者”。
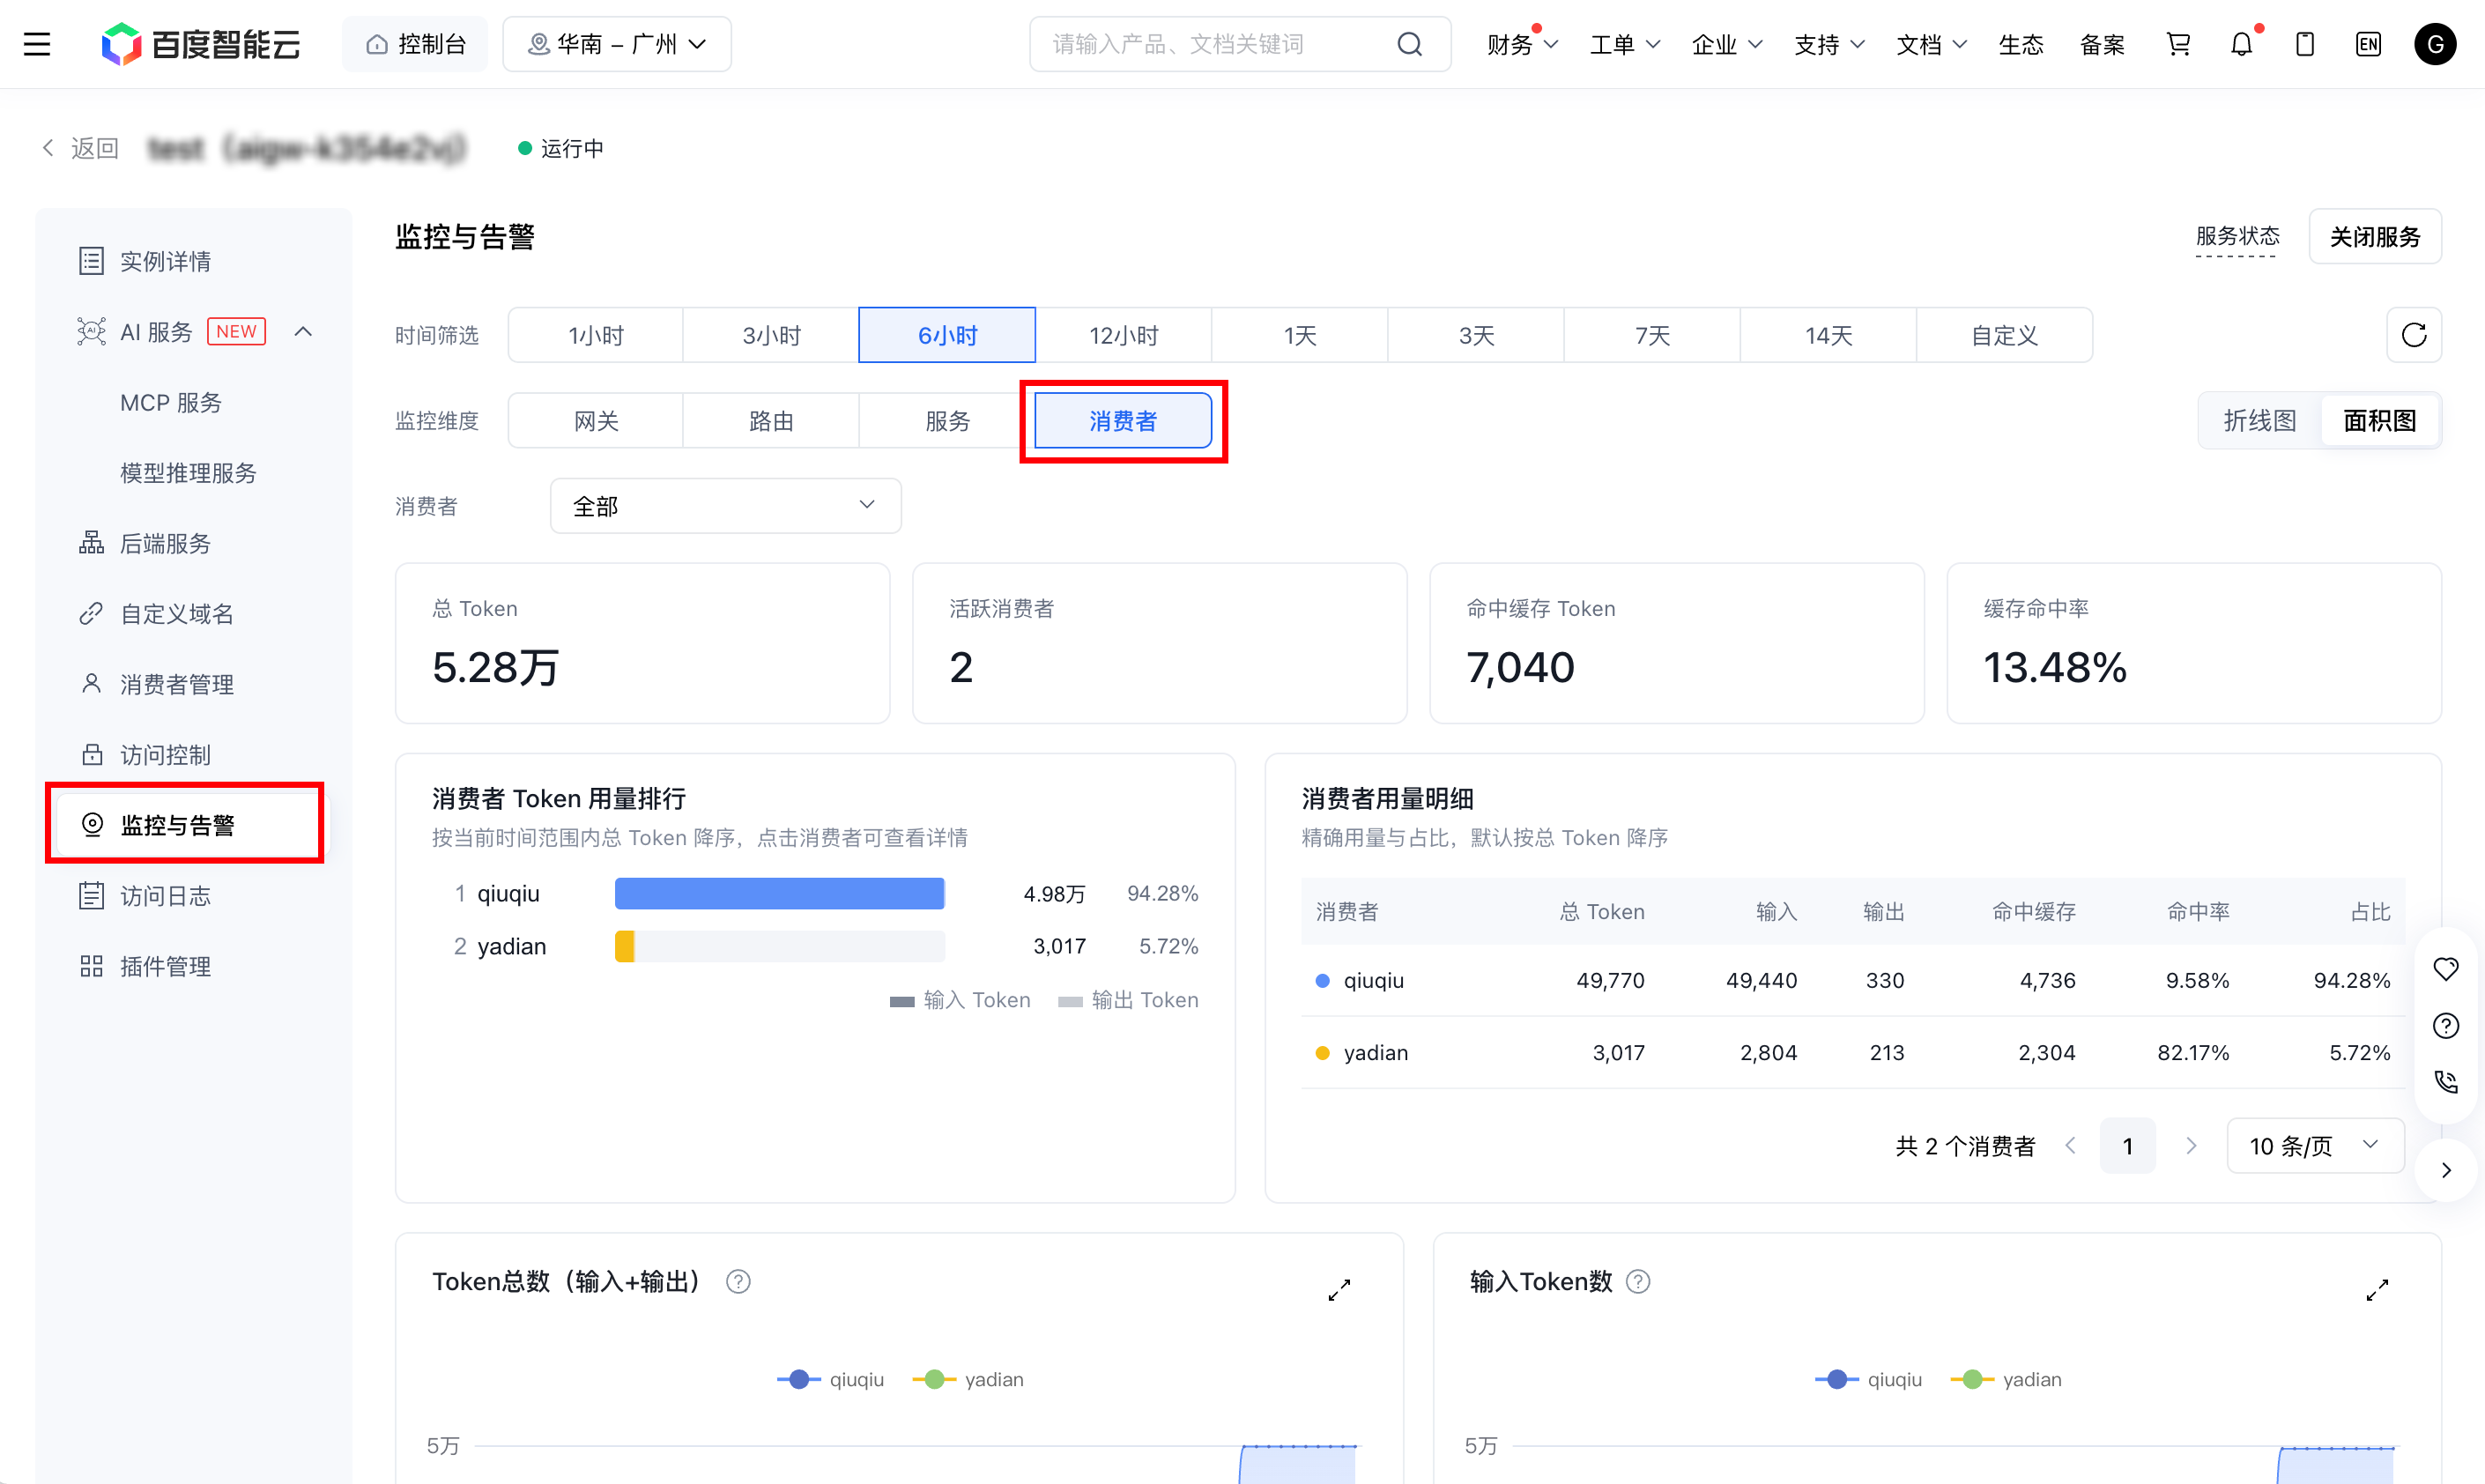
注意: 页面支持查询最近 1 小时、3 小时、6 小时、12 小时、1 天、3 天、7 天和 14 天的数据,也可以选择自定义时间范围。可选时间范围受 Prometheus 监控实例的数据存储时长限制。需要获取最新数据时,可以点击时间筛选区域右侧的刷新按钮。
查看全部消费者
消费者筛选项默认为“全部”。选择“全部”后,页面展示当前时间范围内所有产生过 Token 用量的消费者。
用量概览
页面顶部展示以下数据:
| 指标 | 说明 |
|---|---|
| 总 Token | 当前时间范围内所有消费者的输入 Token 与输出 Token 之和 |
| 活跃消费者 | 当前时间范围内产生过 Token 用量的消费者数量 |
| 命中缓存 Token | 当前时间范围内命中缓存的输入 Token 数量 |
| 缓存命中率 | 命中缓存的输入 Token 占全部输入 Token 的比例 |
缓存命中率按照以下口径计算:
1 缓存命中率 = (命中缓存的输入 Token / 输入 Token 总数) * 100%消费者 Token 用量排行
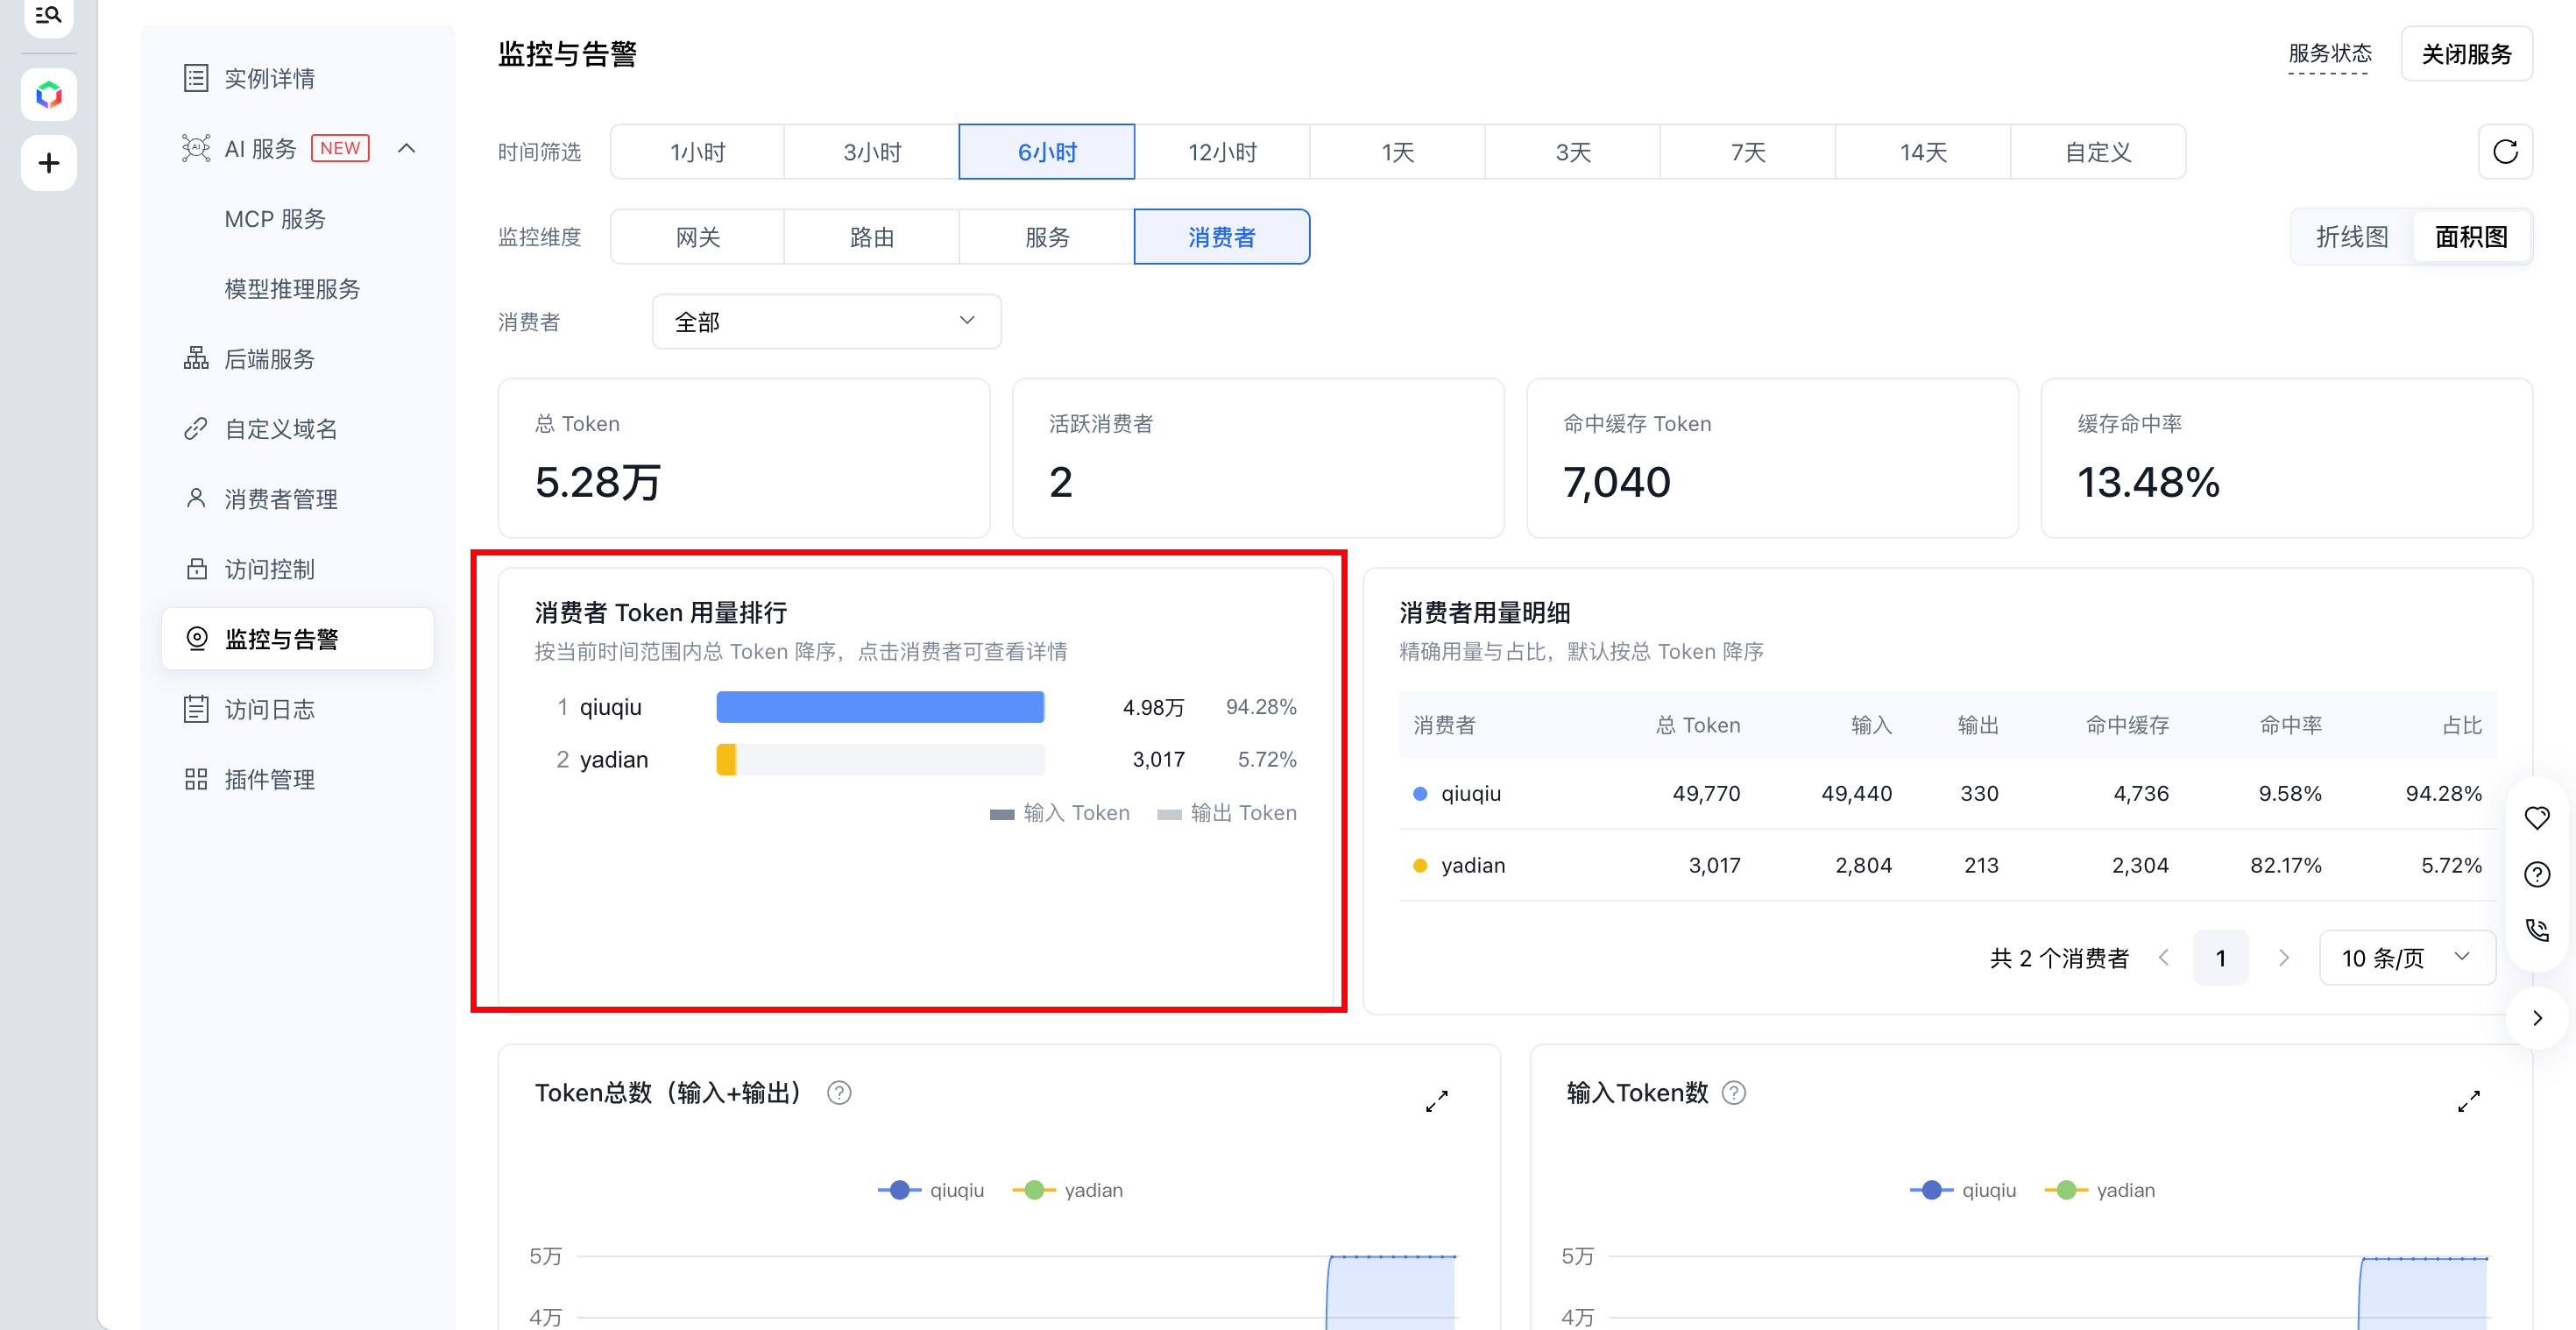
消费者 Token 用量排行按照总 Token 从高到低排列,可以用于识别当前时间范围内用量较高的消费者。
每个消费者的用量由两部分组成:
- 输入 Token:发送给模型的请求内容所消耗的 Token。
- 输出 Token:模型生成内容所消耗的 Token。
排行展示所有消费者,消费者数量较多时可以通过分页查看。点击排行中的消费者,可以直接进入该消费者的详细监控视图。
消费者用量明细
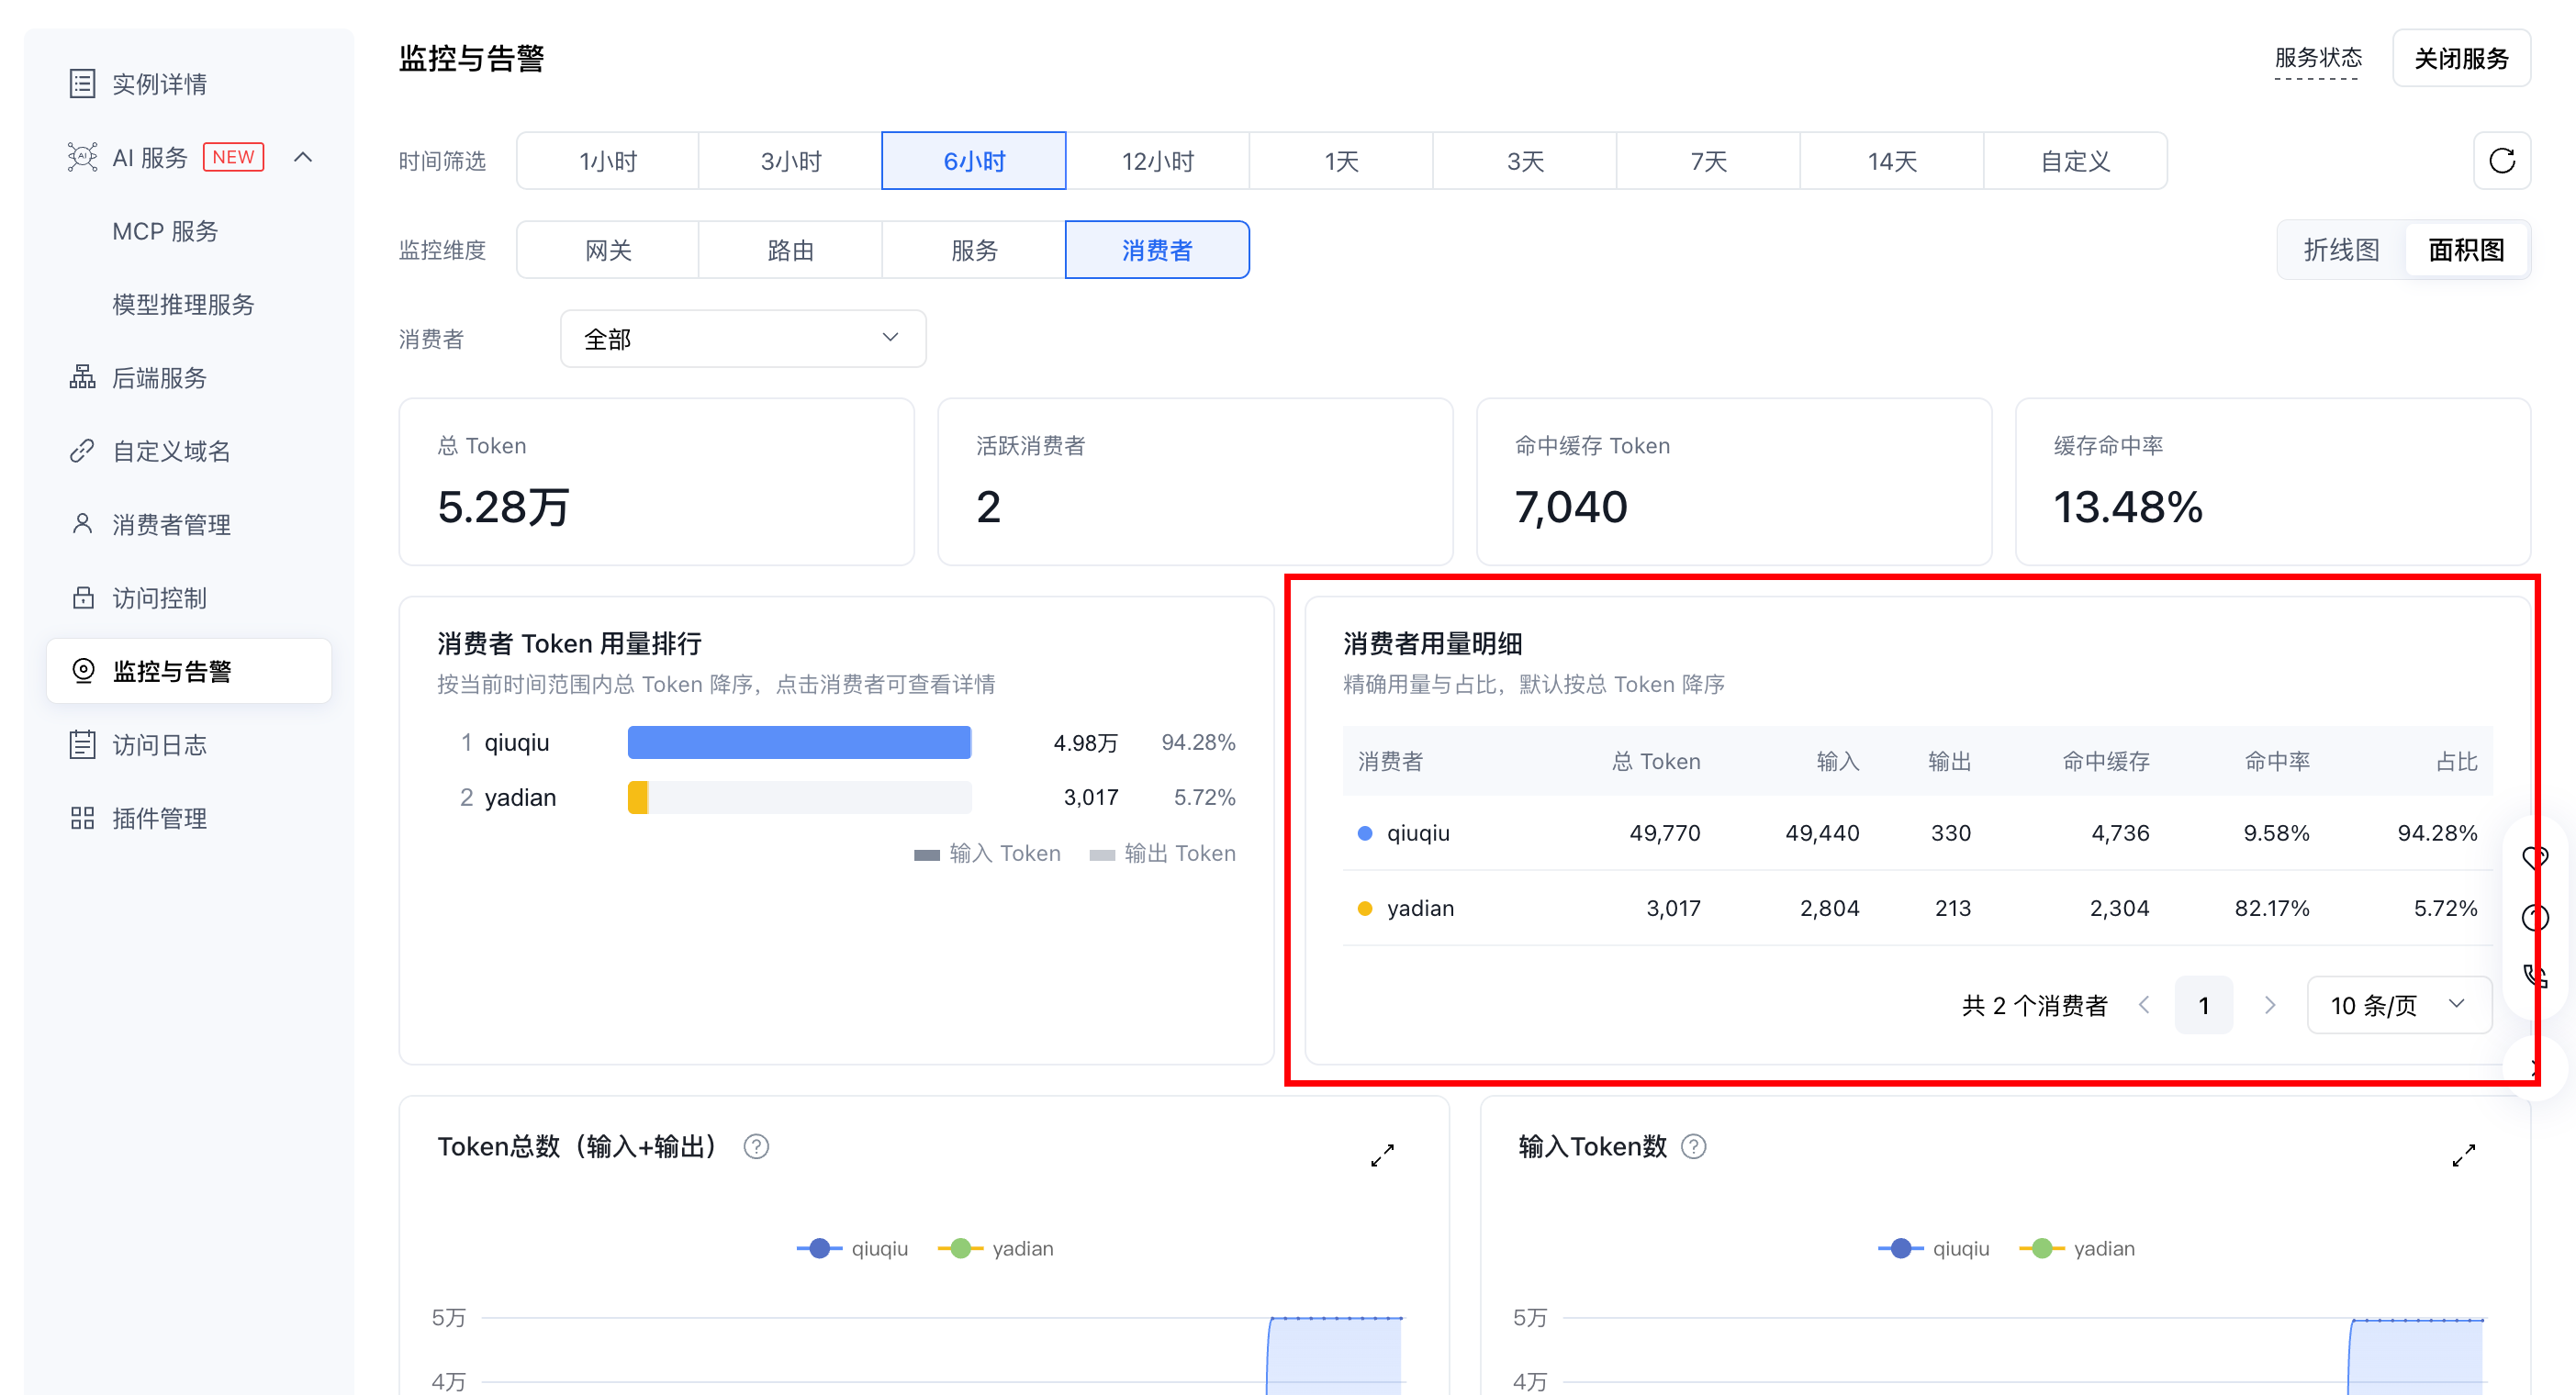
“消费者用量明细”提供每个消费者的精确数据,包括:
- 总 Token
- 输入 Token
- 输出 Token
- 命中缓存 Token
- 缓存命中率
- 用量占比
“用量占比”表示该消费者的总 Token 占当前全部消费者总 Token 的比例。点击明细中的消费者,可以进入单个消费者的详细监控视图。
趋势图
全部消费者视图还提供以下趋势和统计数据:
- Token 总数
- 输入 Token 数
- 输出 Token 数
- 输入 Token 每秒消耗数
- 输出 Token 每秒消耗数
- 命中缓存 Token 数
- 缓存命中率
- 未命中缓存 Token 数
- 服务输入、输出 Token 使用情况
- 模型输入、输出 Token 使用情况
不同图表中的同一消费者使用固定颜色,便于对照查看。可以在页面上方切换折线图或面积图。
“输入 Token 每秒消耗数”和“输出 Token 每秒消耗数”表示最近 5 分钟内的平均每秒消耗量,适合观察短期流量变化;Token 数量类指标表示所选时间范围内产生的用量。
查看单个消费者
在消费者下拉框中选择具体消费者,或者从排行、明细中点击消费者后,页面会切换到单个消费者视图。
消费者用量概览
单个消费者视图展示以下指标:
| 指标 | 说明 |
|---|---|
| 总 Token | 该消费者的输入 Token 与输出 Token 之和 |
| 输入 Token | 该消费者发送给模型的 Token 数量 |
| 输出 Token | 模型为该消费者生成的 Token 数量 |
| 缓存命中率 | 该消费者命中缓存的输入 Token 比例 |
| 预计节省 Token | 命中缓存、无需再次提交给模型处理的输入 Token 数量 |
| 未命中缓存 Token | 输入 Token 中未命中缓存的部分 |
未命中缓存 Token 按照以下口径计算:
1 未命中缓存 Token = 输入 Token 总数 - 命中缓存 Token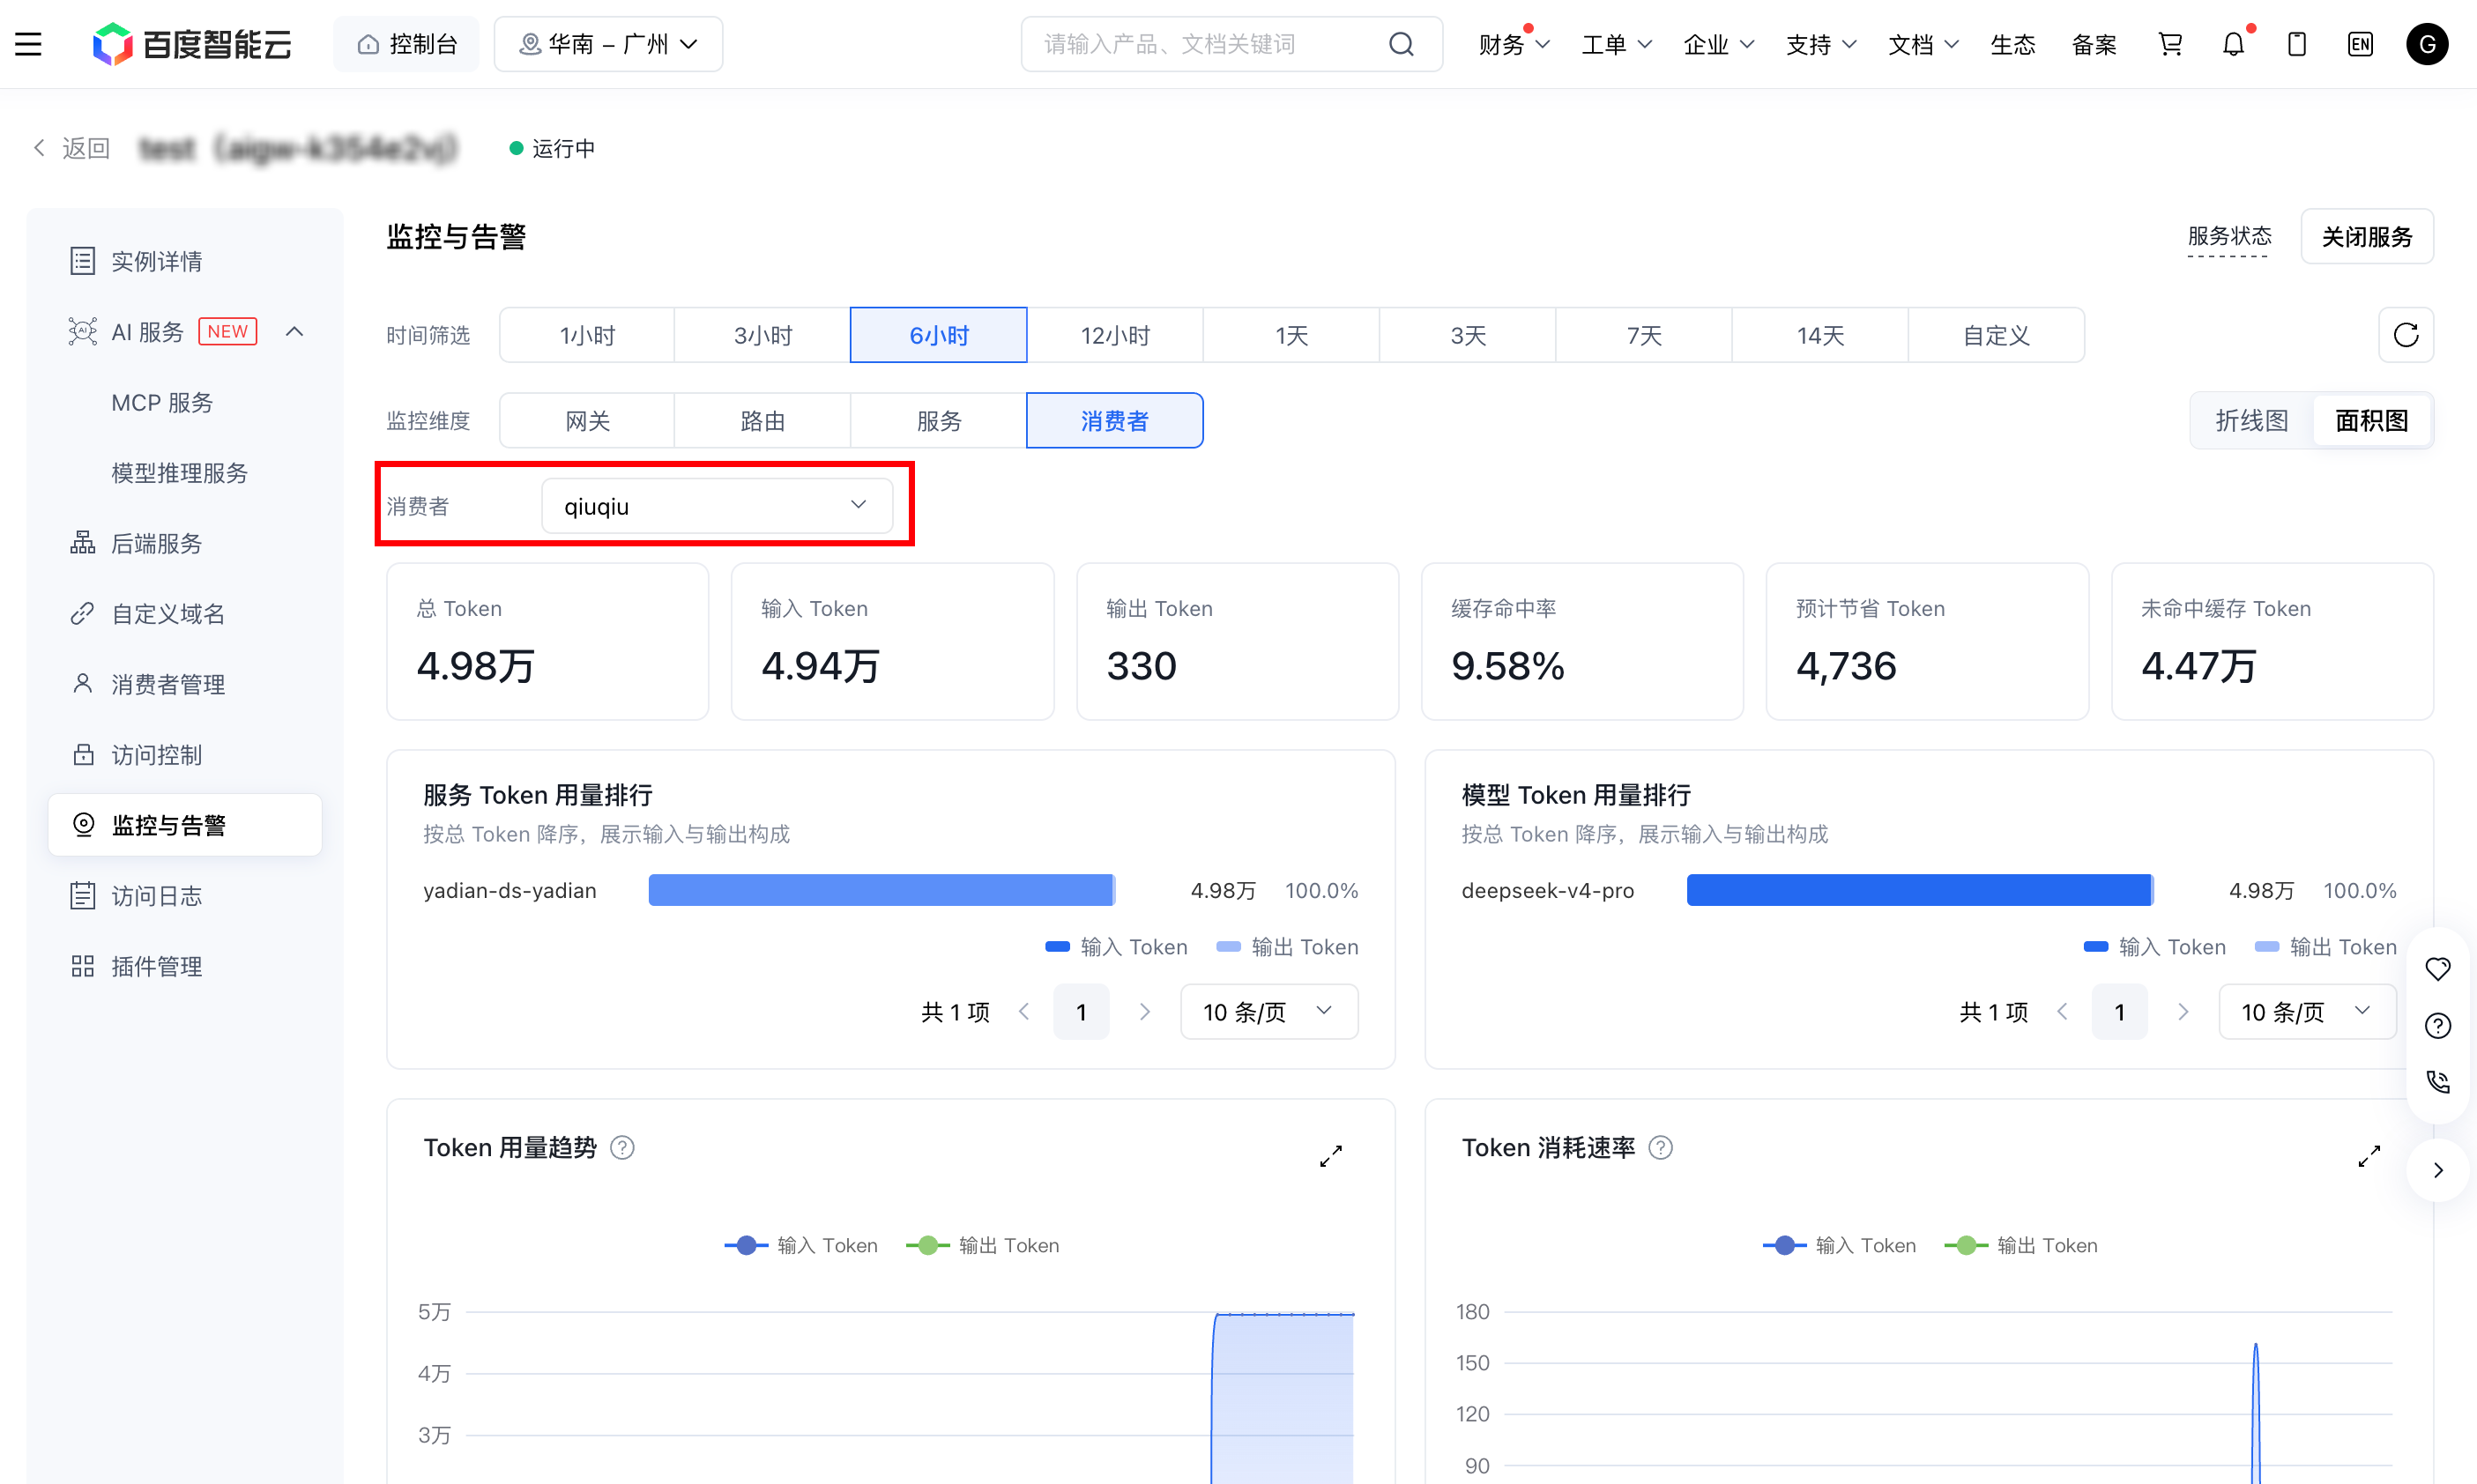
服务 Token 用量排行
“服务 Token 用量排行”展示该消费者访问不同服务时产生的 Token 用量,并按照总 Token 从高到低排列。可以通过该排行查看该消费者主要访问的服务、各服务的输入和输出 Token,以及各服务的 Token 用量占比。
服务数量较多时,可以通过分页查看全部服务。
模型 Token 用量排行
“模型 Token 用量排行”展示该消费者使用不同模型产生的 Token 用量,并按照总 Token 从高到低排列。可以通过该排行查看该消费者主要使用的模型、各模型的输入和输出 Token,以及各模型的 Token 用量占比。
模型数量较多时,可以通过分页查看全部模型。
核心趋势
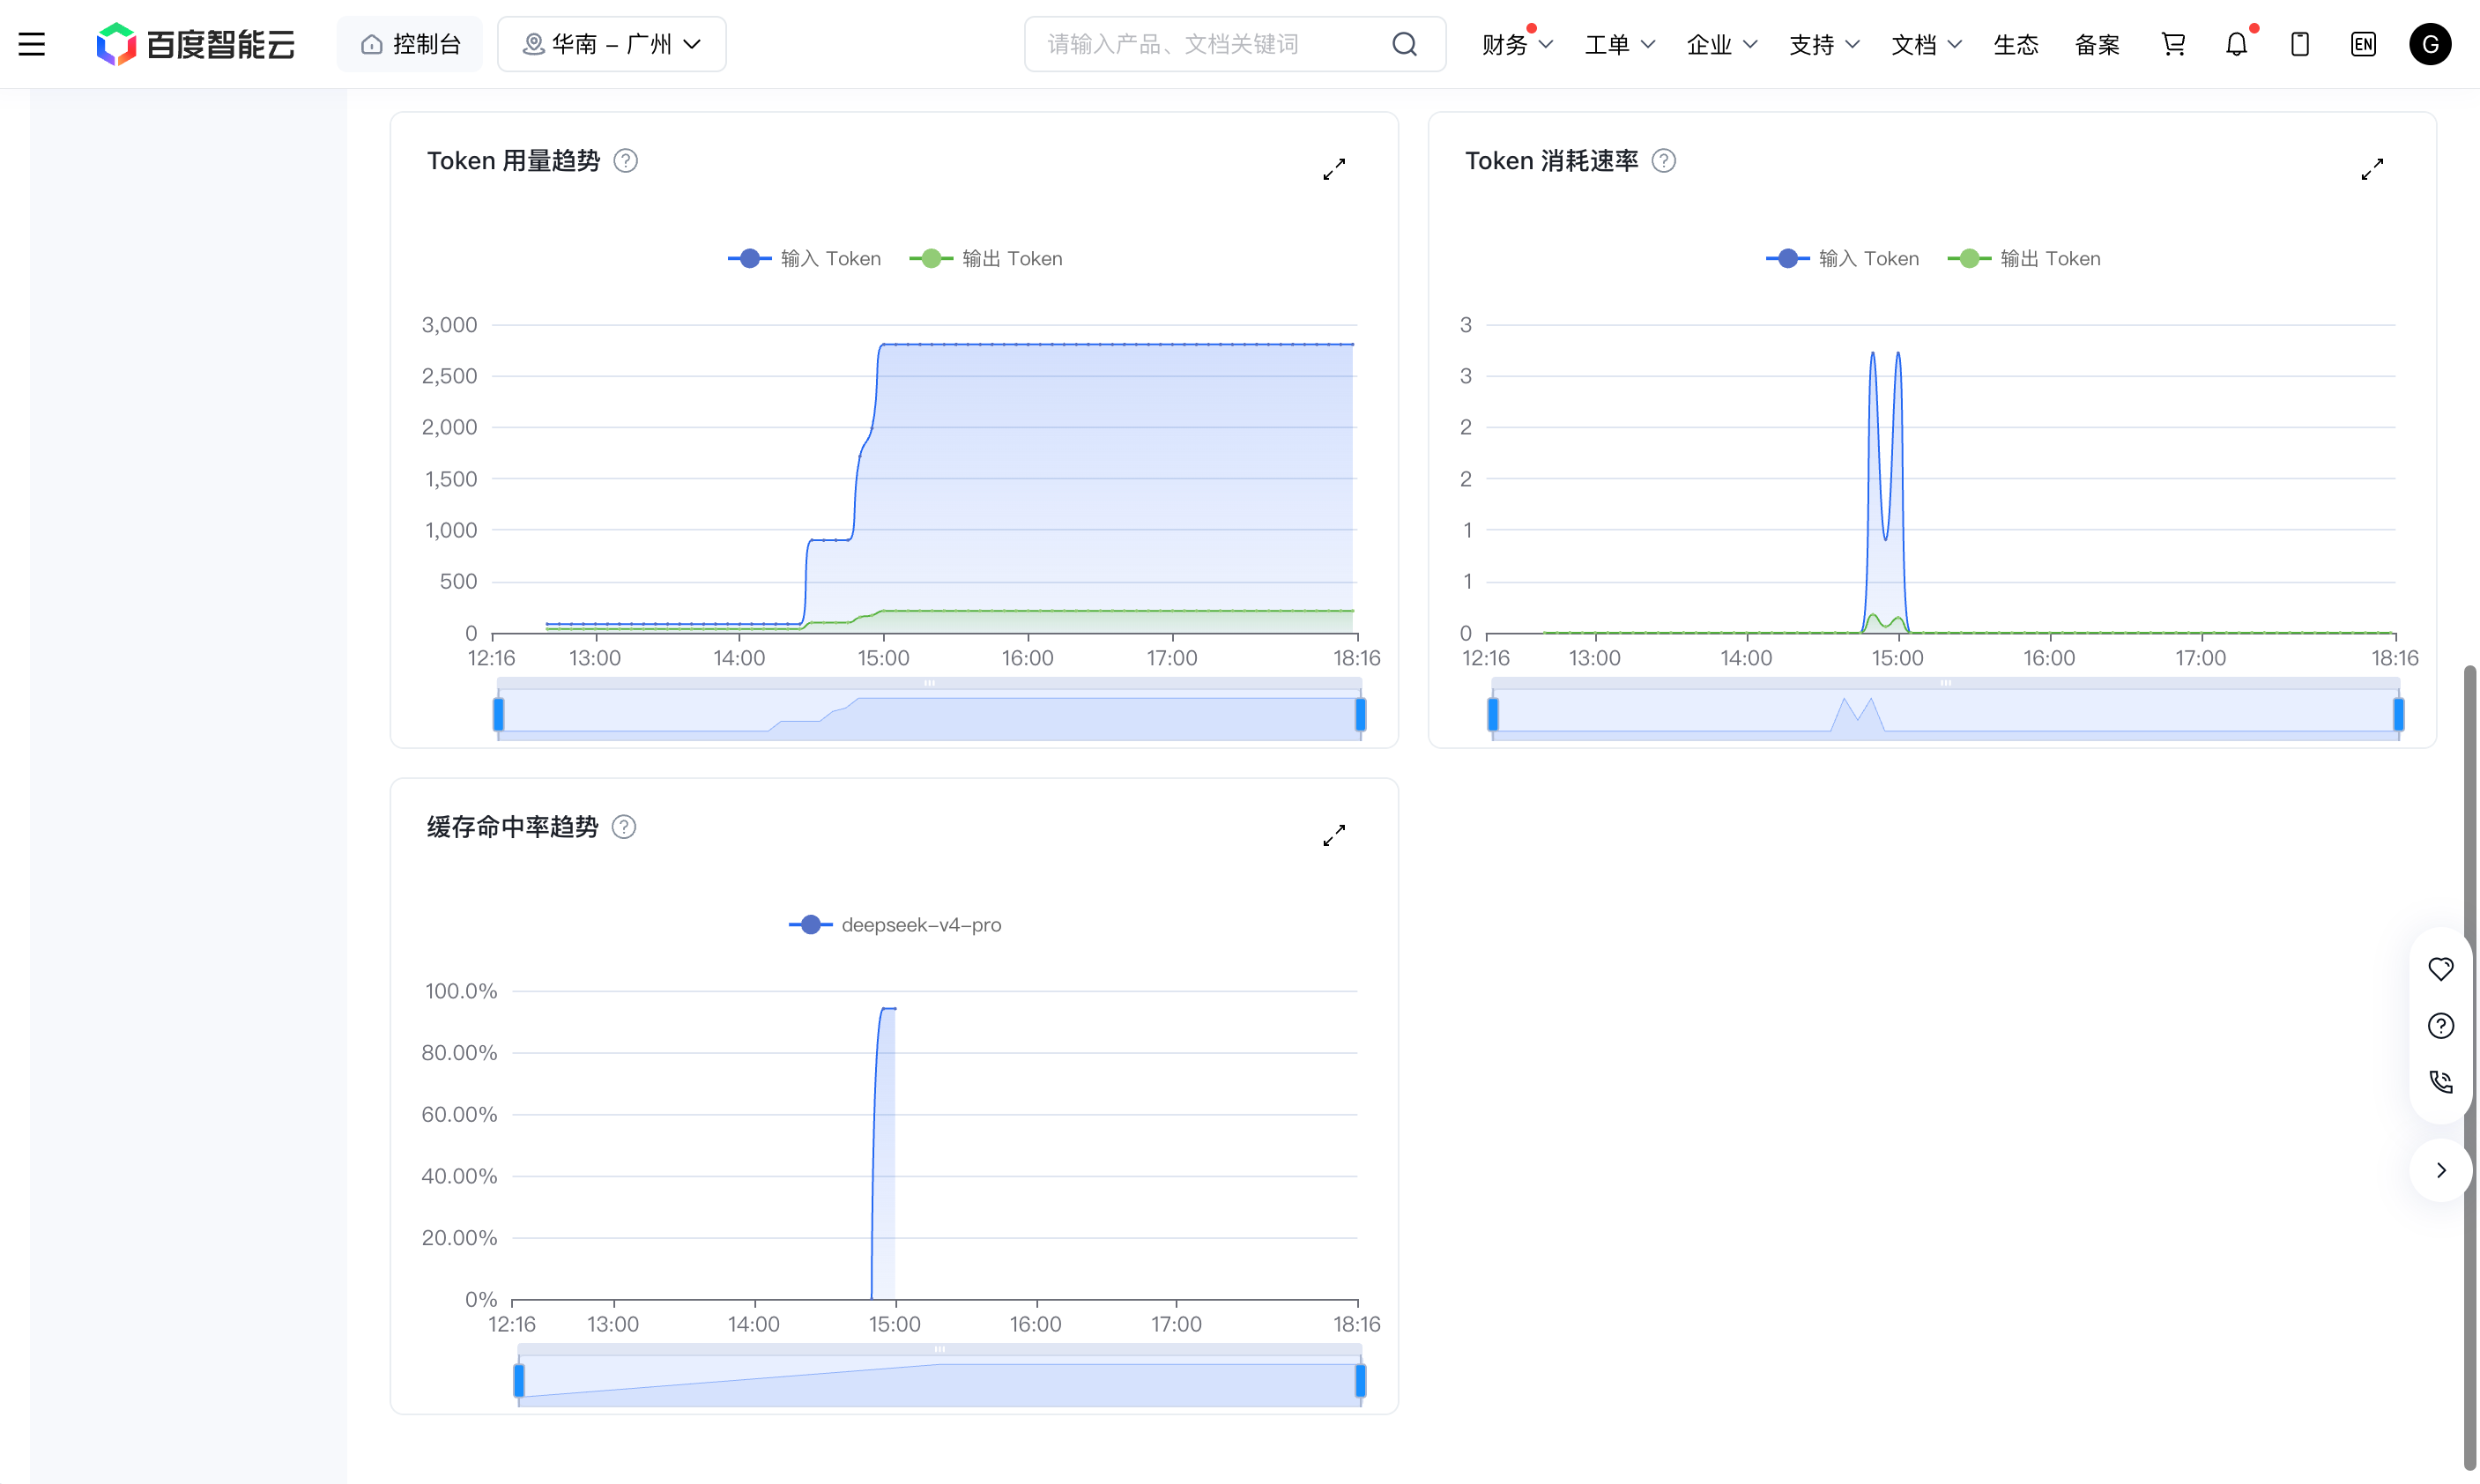
单个消费者视图提供以下趋势图:
- Token 用量趋势:展示输入 Token 和输出 Token 随时间的变化。
- Token 消耗速率:展示最近 5 分钟输入、输出 Token 的每秒平均消耗量。
- 缓存命中率趋势:展示最近 5 分钟命中缓存的输入 Token 占比。
没有监控数据时如何处理
如果消费者维度没有数据,可以依次检查:
- 当前网关实例是否已经创建消费者。
- 请求是否使用该消费者对应的 API Key。
- 请求是否通过当前网关实例访问 AI 服务。
- 所选时间范围是否覆盖实际请求发生的时间。
- Prometheus 监控实例是否处于正常运行状态。
- 监控数据可能存在短暂延迟,可以等待片刻后点击刷新按钮。
如果页面提示“当前实例暂无消费者”,需要先创建消费者;如果消费者已经存在但没有用量数据,需要先使用该消费者的 API Key 产生实际调用。
缓存命中 Token 和缓存命中率只有在请求实际命中缓存后才会产生数据。未命中缓存,或者上游没有上报缓存 Token 指标时,缓存命中率将显示为 0%。
评价此篇文章