

实时语音识别大模型
接口描述
实时语音识别大模型采用 WebSocket 协议,支持音频流实时上传与识别结果同步返回,实现边说边识别、边识别边返回文字。依托新一代语音识别大模型,提升多语种、方言、不同口音及复杂噪声环境下的识别准确率,兼顾识别精度与响应速度。
接口支持实时音频流输入,也可通过分帧发送本地音频文件进行识别,返回中间识别结果、最终识别文本及句级时间戳,适用于语音输入、实时字幕、直播质检、会议记录等场景。(本接口处于邀测阶段,请提交合作咨询申请测试)
主要流程
- 建立连接: 客户端通过 WebSocket 地址发起连接请求,完成鉴权及协议握手。
- 发送开始帧: 连接建立后,发送
START文本帧,指定识别模型、音频格式和采样率等参数。 - 发送音频数据: 将音频划分为多个二进制帧,按照实时音频采集节奏持续上传。
- 接收识别结果: 服务端通过
MID_TEXT返回中间识别结果,通过FIN_TEXT返回单句最终识别结果及时间信息。客户端可在发送音频的同时持续接收结果。 - 结束识别: 音频发送完成后,客户端发送
FINISH文本帧,等待服务端返回剩余识别结果。 - 关闭连接: 服务端完成识别后主动关闭 WebSocket 连接,客户端根据连接关闭事件完成资源释放。
如需提前终止识别,客户端可发送 CANCEL 文本帧,取消本次识别任务。
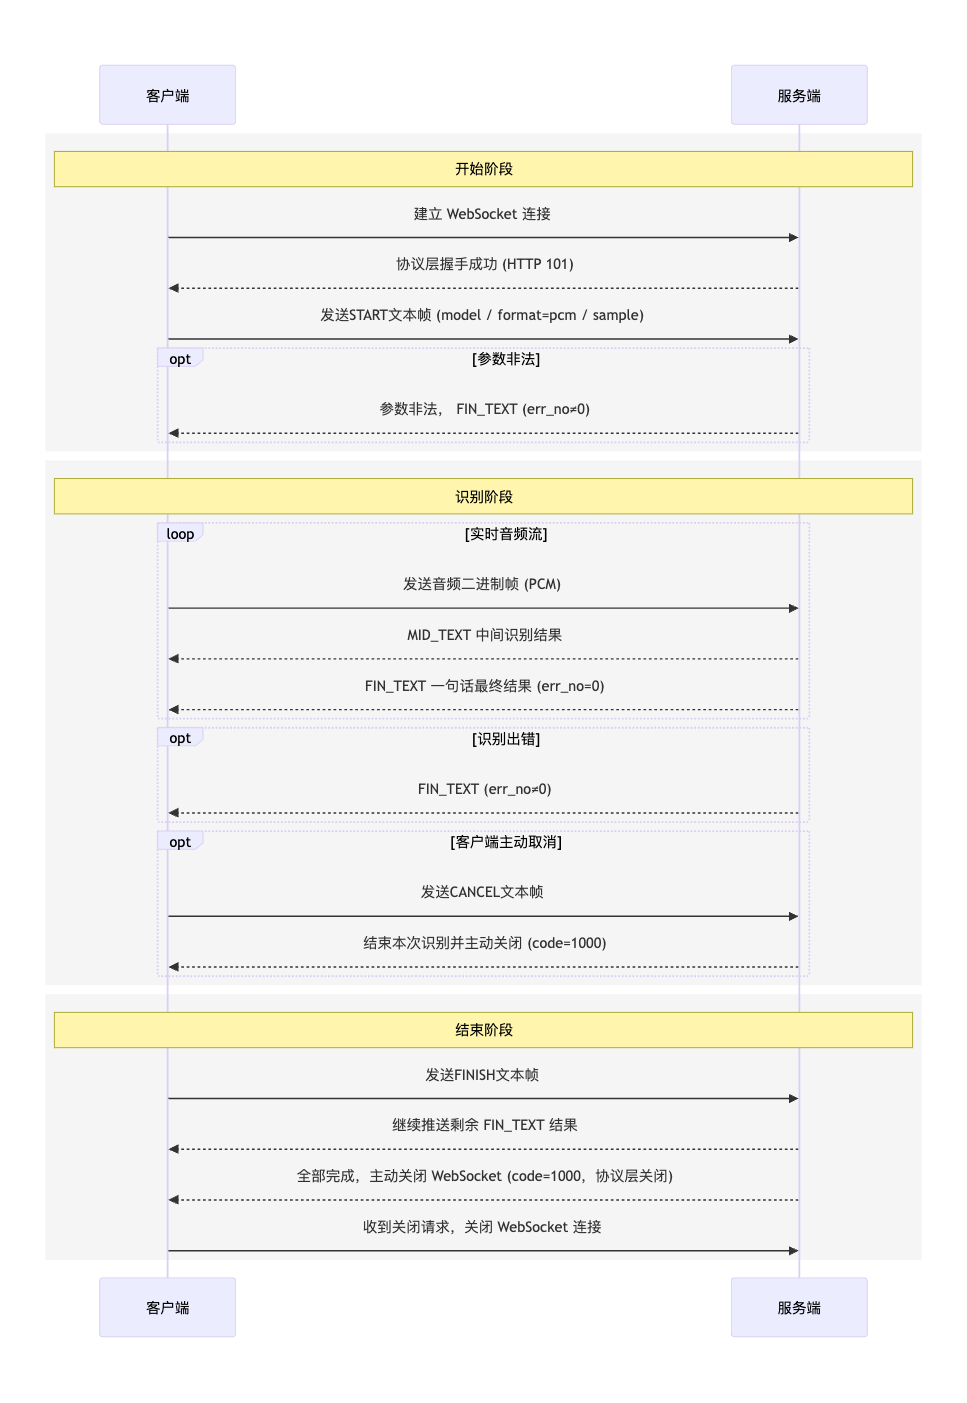
请求说明
建立 WebSocket 连接
请求地址:wss://aip.baidubce.com/ws/2.0/speech/publiccloudspeech/v1/asr
鉴权方式: 支持 Access Token 和 API Key 两种鉴权方式,任选其一即可。
方式一:Access Token 鉴权
通过 URL Query 参数传入 Access Token:wss://aip.baidubce.com/ws/2.0/speech/publiccloudspeech/v1/asr?sn={sn}&access_token={access_token}
方式二:API Key 鉴权
通过 WebSocket 握手请求的 Header 传入:Authorization: Bearer {api_key}
连接参数:
| 参数名 | 类型 | 是否必填 | 描述 |
|---|---|---|---|
| sn | string | 否 | 请求唯一标识,建议使用 UUID,便于日志排查 |
| access_token | string | 与 API Key 二选一 | Access Token 鉴权凭证 |
sn 支持英文字母、数字及连字符 -,长度不超过 128 个字符。
注意:Access Token 与 API Key 两种鉴权方式任选其一,不需要同时传入。请避免在应用日志中输出完整鉴权凭证。
发送开始参数帧(START)
WebSocket 连接建立成功后,客户端首先发送 START 文本帧,初始化语音识别会话。注意帧的类型(Opcode)是Text, 使用json序列化
示例:
1{
2    "type": "START",
3    "data": {
4        # 下面是固定参数
5        "model": "qianfan-asr-v1", # 识别模型
6        "format": "pcm",
7        "sample": 16000
8    }
9}
具体参数说明
| 参数名称 | 类型 | 是否必填 | 说明 |
|---|---|---|---|
| type | string | 必填 | START,开始帧的类型 |
| data | object | 必填 | 具体见下表 |
data参数说明
| 参数名称 | 类型 | 是否必填 | 说明 |
|---|---|---|---|
| model | string | 必填 | 识别模型名称,当前支持 qianfan-asr-v1 |
| format | string | 必填 | 音频格式,固定为 pcm |
| sample | int | 必填 | 音频采样率,支持 8000 或 16000 Hz,推荐 16000 Hz |
实时语音识别大模型支持 8 kHz 或 16 kHz、16-bit、单声道 PCM 音频,采用小端字节序(s16le),每个采样点占用 2 字节。请求参数
format必须设置为pcm,推荐使用 16 kHz 采样率,以获得更好的识别效果。
发送音频数据帧
注意帧的类型(Opcode)是Binary
内容是二进制的音频内容。 除最后一个音频数据帧, 每个帧的音频数据长度为20-200ms。
对于离线文件,建议按实时速度发送音频,即发送一个特定时长的音频帧之后,下一个音频帧需要间隔相应的时长后再发送。
发送结束帧
注意帧的类型(Opcode)是Text, 使用json序列化
示例:
1{
2    "type":"FINISH"
3}
具体参数说明
| 参数名称 | 类型 | 是否必填 | 说明 |
|---|---|---|---|
| type | String | 必填,固定值 | 结束帧的类型 |
发送取消帧
取消与结束不同,结束表示音频正常结束,取消表示不再需要识别结果,服务端会迅速关闭连接 示例:
1{
2    "type":"CANCEL"
3}
具体参数说明
| 参数名称 | 类型 | 是否必填 | 说明 |
|---|---|---|---|
| type | String | 必填,固定值 | CANCEL 立即取消本次识别 |
返回说明
接收数据帧
注意需要接收的帧类型(Opcode)是Text, 本接口不会返回Binary类型的帧。 text的内容, 使用json序列化
临时及最终识别结果
一段音频由多句话组成,实时识别api会依次返回每句话的临时识别结果和最终识别结果
一句话的临时识别结果示例:
1{
2    "err_no":0,
3    "err_msg":"OK",
4    "type": "MID_TEXT",
5    "result": "北京天气怎",
6    "log_id": 45677785,
7    "sn": "399427ce-e999-11e9-94c8-fa163e4e6064_ws_2"
8}
一句话的最终识别结果:
1{
2    "type":"FIN_TEXT",
3    "result":"北京天气怎么样",
4    "start_time":53220,
5    "end_time":73340,
6    "err_no":0,
7    "err_msg":"OK",
8    "log_id":45677785,
9    "sn":"399427ce-e999-11e9-94c8-fa163e4e6064_ws_2"
10}服务端报错如-3005错误码,是针对的是一个句子的,其它句子依旧可以识别,请求是否结束以服务端是否关闭连接为准。 具体错误码含义见“错误码“
1{
2    "err_msg": "asr authentication failed",
3    "err_no": -3004,
4    "log_id": 106549729,
5    "result": "",
6    "sn": "0d25b5e1-ffa6-11e9-8968-f496349f3917",
7    "type": "FIN_TEXT"
8}
一句话的开始时间及结束时间:识别过程中,百度服务端在每句话的最终识别结果中带有这句话的开始和结束时间。最终识别结果是指"type":"FIN_TEXT",即一句话的最后识别结果,包括这句话的报错结果。
通常一个音频会得到如下的时间信息:
1 # s1 e1 指第一句话的开始和结束时间start_time,end_time
2[静音][s1:e1][静音][s2:e2]....[静音][s10:e10][静音]
3建议一句话不要超过30s,否则识别准确性会有影响或会被强制切割
参数说明
| 参数名称 | 名称 | 类型 | 说明 |
|---|---|---|---|
| err_no | 错误码 | int | 0 表示正确, 其它错误码见文末 |
| err_msg | 错误信息 | string | err_no!=0时,具体的报错解释 |
| type | 结果类型 | string | 结果类型:MID_TEXT 为中间结果,FIN_TEXT 为单句最终结果或错误结果 |
| ~ | ~ | MID_TEXT | 一句话以及临时识别结果 |
| ~ | ~ | FIN_TEXT | 一句话的最终识别结果或者报错, 是否报错由err_no判断 |
| result | 识别结果 | string | 音频的识别结果 |
| start_time | 一句话的开始时间 | int,毫秒 | 一句话的开始时间,临时识别结果MID_TEXT 无此字段 |
| end_time | 一句话的结束时间 | int,毫秒 | 一句话的结束时间,临时识别结果MID_TEXT 无此字段 |
| log_id | 日志id | string | 日志id,用这个id可以百度服务端定位请求,排查问题 |
| sn | 请求sn | string | 用这个sn可以百度服务端定位请求,排查问题。ws URI里的参数及识别句子的组合 |
示例代码
1# -*- coding: utf-8 -*-
2"""
3百度实时语音识别(Realtime ASR)WebSocket Demo
4
5调用流程:
6    1. 建立连接           ws_app.run_forever()
7    2. 连接成功回调        on_open()
8       2.1 发送开始帧      send_start()   —— 告知音频格式、采样率、模型
9       2.2 循环发送音频    分片读取 PCM 并按实时节奏发送
10       2.3 接收识别结果    on_message()   —— 服务端返回中间/最终结果
11       2.4 发送结束帧      send_finish()  —— 通知服务端音频发送完毕
12    3. 连接关闭回调        on_close()
13    库层面报错回调          on_error()     —— 如连接超时、网络中断
14
15小提示:
16    运行前加环境变量可让日志实时刷新,方便定位问题:
17        PYTHONUNBUFFERED=1 python ws_demo.py
18"""
19import argparse
20import json
21import time
22import uuid
23import logging
24import threading
25
26import websocket
27
28# ============================ 可配置参数 ============================
29# 音频参数:必须与实际 PCM 文件保持一致,否则识别结果会异常
30SAMPLE_RATE = 16000        # 采样率(Hz):8k 电话音质 / 16k 近场音质
31CHUNK_MS = 160            # 每帧音频时长(ms):模拟实时流的发送粒度
32MODEL = "qianfan-asr-v1"           # 模型 ID(语言/场景),按业务需求选择
33
34# 待识别的音频文件:16bit 单声道 PCM,采样率需等于 SAMPLE_RATE
35AUDIO_FILE = "xi.pcm"
36
37# 百度公有云 ASR 接入地址(仅保留线上域名,走 wss 加密连接)
38ADDR = "aip.baidubce.com"
39PATH = "/ws/2.0/speech/publiccloudspeech/v1/asr"
40
41# ===== 鉴权方式(二选一,也可用命令行 --auth 指定)=====
42# 方式一:access_token(URL 参数,默认)
43ACCESS_TOKEN = "your_access_token"
44# 方式二:API_KEY 放请求 header(需配合 URL 上的 client_id=<API_KEY>)
45API_KEY = "your_api_key"                            # 控制台获取的 API Key
46API_KEY_HEADER = "Authorization"  # API Key 所在 header 名称,按服务端要求调整
47AUTH_MODE = "apikey"                     # 默认 token;可改 "apikey",或用命令行 --auth 指定
48# ===================================================================
49
50
51def send_start(ws):
52    """发送开始参数帧:声明音频格式、采样率与模型,服务端据此初始化识别会话。"""
53    req = {
54        "type": "START",
55        "data": {
56            "model": MODEL,
57            "format": "pcm",
58            "sample": SAMPLE_RATE,
59        },
60    }
61    body = json.dumps(req)
62    ws.send(body, websocket.ABNF.OPCODE_TEXT)
63    print("send START frame:", body)
64
65
66def send_finish(ws):
67    """发送结束帧:告知服务端音频已发送完毕,等待返回最终结果后关闭连接。"""
68    req = {"type": "FINISH"}
69    body = json.dumps(req)
70    ws.send(body, websocket.ABNF.OPCODE_TEXT)
71    print("send FINISH frame:", body)
72
73
74def on_open(ws):
75    """连接建立成功后触发:另起线程发送音频,避免阻塞库的收包循环。"""
76
77    def run():
78        print("Start sending audio frames...")
79        send_start(ws)
80
81        # 每帧字节数 = 采样率 * 2字节(16bit) * 帧时长(秒)
82        chunk_bytes = int(SAMPLE_RATE * 2 * CHUNK_MS / 1000)
83        try:
84            with open(AUDIO_FILE, "rb") as f:
85                while True:
86                    audio_data = f.read(chunk_bytes)
87                    if not audio_data:      # 读到文件末尾,音频发送完毕
88                        break
89                    ws.send(audio_data, opcode=websocket.ABNF.OPCODE_BINARY)
90                    # 按帧时长 sleep,模拟麦克风实时采集的节奏
91                    time.sleep(CHUNK_MS / 1000)
92        except Exception as e:
93            logging.error(f"读取/发送音频出错: {e}")
94
95        send_finish(ws)
96
97    threading.Thread(target=run, daemon=True).start()
98
99
100def on_message(ws, message):
101    """接收服务端返回的识别结果(JSON 文本帧),业务侧自行解析所需字段。"""
102    if isinstance(message, str):
103        msg = json.loads(message)
104        print("Received JSON:", msg, time.time())
105
106
107def on_error(ws, error):
108    """库层面报错回调:如连接超时、网络中断等。"""
109    print("error:", error)
110
111
112def on_close(ws, close_status_code, close_msg):
113    """连接关闭回调:close_status_code 为 WebSocket 关闭码,正常关闭为 1000。"""
114    print(f"Websocket closed, status_code: {close_status_code}, server message: {close_msg}")
115
116
117if __name__ == "__main__":
118    parser = argparse.ArgumentParser(description="百度实时语音识别 WebSocket Demo")
119    parser.add_argument(
120        "--auth", "-a", choices=["token", "apikey"], default=AUTH_MODE,
121        help="鉴权方式: token(access_token, 默认) 或 apikey(API Key 放 header)",
122    )
123    parser.add_argument("--audio", default=AUDIO_FILE, help="音频文件路径(16k PCM)")
124    args = parser.parse_args()
125
126    auth_mode = args.auth
127    AUDIO_FILE = args.audio
128    if auth_mode == "apikey" and not API_KEY:
129        print("[WARN] 使用 apikey 鉴权但脚本顶部 API_KEY 为空,服务端会返回鉴权失败")
130
131    # sn:本次会话的唯一标识,服务端日志可按 sn 定位对应会话
132    sn = uuid.uuid4()
133    if auth_mode == "apikey":
134        # API Key 方式:URL 带 client_id=<API_KEY>,API Key 放 header
135        uri = f"wss://{ADDR}{PATH}?sn={sn}"
136        headers = [f"{API_KEY_HEADER}: {API_KEY}"]
137    else:
138        # access_token 方式:token 放 URL 参数
139        uri = f"wss://{ADDR}{PATH}?sn={sn}&access_token={ACCESS_TOKEN}"
140        headers = []
141    print("uri is " + uri)
142    print(f"鉴权方式: {auth_mode}" + (f", header: {headers}" if headers else ""))
143
144    ws_app = websocket.WebSocketApp(
145        uri,
146        header=headers,
147        on_open=on_open,        # 连接建立后的回调
148        on_message=on_message,  # 接收消息的回调
149        on_error=on_error,      # 库遇见错误的回调
150        on_close=on_close,      # 关闭后的回调
151    )
152    try:
153        # ping_timeout:心跳超时(秒),超时未收到 pong 则判定连接异常
154        ws_app.run_forever(ping_timeout=6)
155    except websocket._exceptions.WebSocketTimeoutException:
156        print("Connection timeout!")
附:错误码详情
报错示例:
1{
2    "err_msg": "asr authentication failed",
3    "err_no": -3004,
4    "log_id": 106549729,
5    "result": "",
6    "sn": "0d25b5e1-ffa6-11e9-8968-f496349f3917",
7    "type": "FIN_TEXT"
8}
err_no = 0 是正确,非0值即为报错。 在err_msg中一般有更具体的报错信息。
| 错误码err_no | 错误方 | 原因 | 解决方法 | 是否会识别并关闭连接 |
|---|---|---|---|---|
| -3003 | 百度服务端问题 | 服务后端异常 | 记录报错json并反馈 | 这一句话报错,不影响后续识别 |
| -3004 | 调用方问题 | 鉴权失败,没有权限调用接口 | 查看appid appkey devpid这3个参数有无填对,QPS有无超限 | 是 |
| -3005 | 调用方问题 | 音频质量问题,无效音频 | 根据start_time和end_time可以听下是否是噪音 | 这一句话报错,不影响后续识别 |
| -3006 | 百度服务端问题 | 服务后端VAD异常 | 记录报错json并反馈 | 是 |
| -3008 | 调用方问题 | 开始参数帧参数错误,包括漏写 | 检测参数有无缺失及格式正确,在err_msg中有更具体的报错信息 | 是 |
| -3011 | 用户网络问题 | 上行流建立失败,可能跟网络状况或后端有关 | 重试 | 是 |
| -3012 | 用户网络问题 | 下行流建立失败,可能跟网络状况或后端有关 | 重试 | 是 |
| -3013 | 百度服务端问题 | 服务后端异常 | 记录报错json并反馈 | 这一句话报错,不影响后续识别 |
| -3014 | 调用方正常调用CANCEL | 用户取消 | 如果发送取消帧后会有此返回,可以忽略 | 是 |
| -3101 | 调用方问题 | 一段时间没发出音频数据,导致整体请求超时 | 确认代码有音频数据一直在发送中 | 是 |
评价此篇文章