产品概述
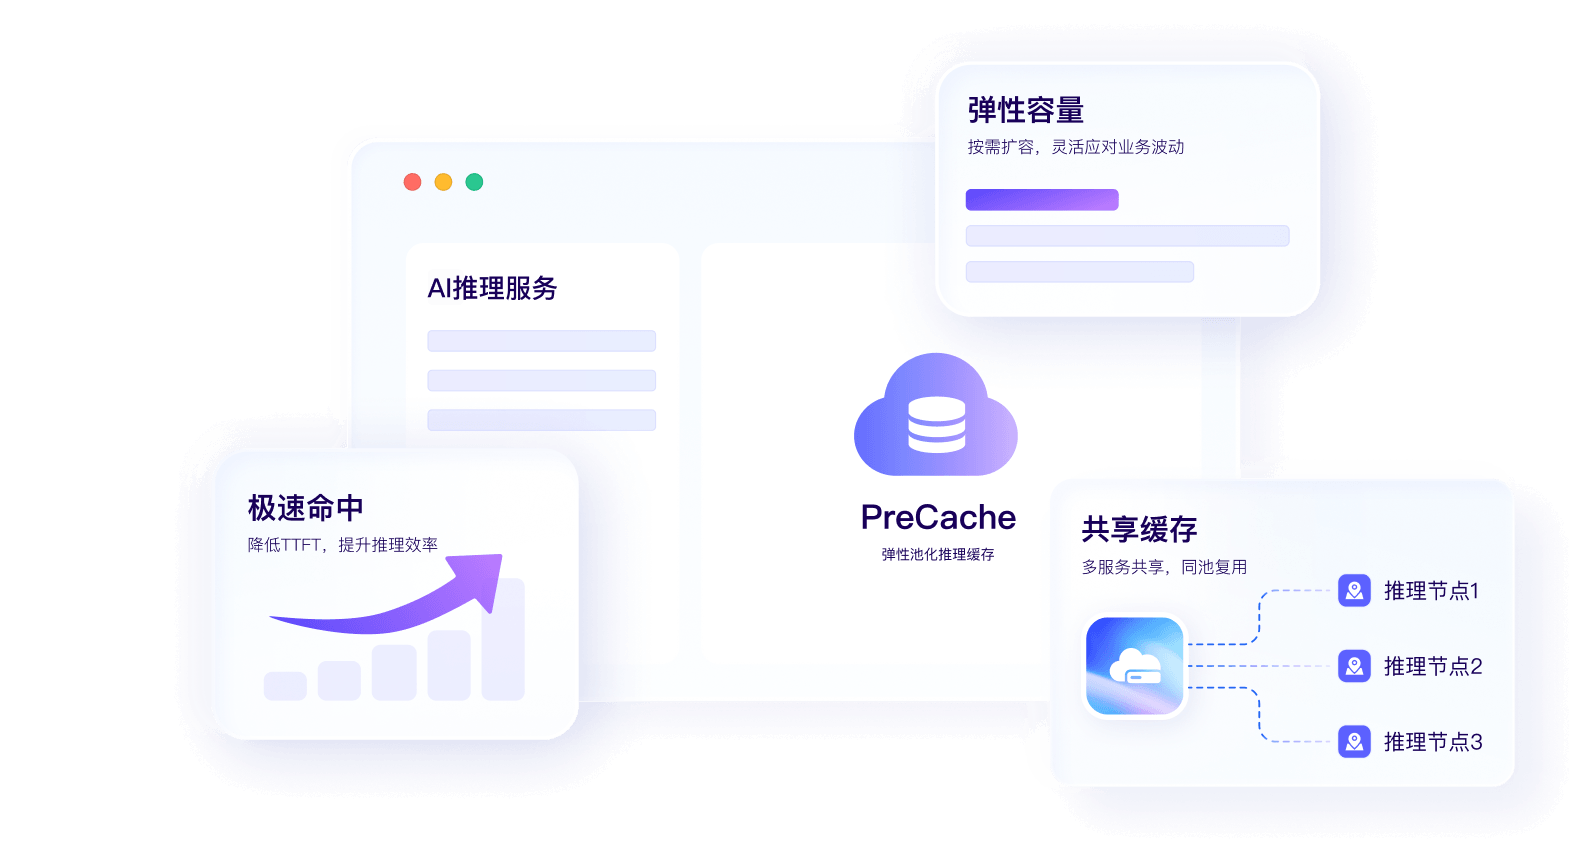
弹性池化推理缓存 PreCache 定位于 G3.5,是面向大模型推理场景的远端高速缓存服务,提供大容量、低延迟、高吞吐的 KVCache 共享缓存能力,具备 GPU 就近亲和性访问、弹性扩容等特点。可独立创建和管理缓存池实例,并将实例接入 Mooncake、SGLang、vLLM 等大模型推理服务系统中,用于提升 Cache 命中率、降低重复 Prefill 成本、缩短 TTFT,提升推理吞吐。
产品功能
远端 KVCache 缓存
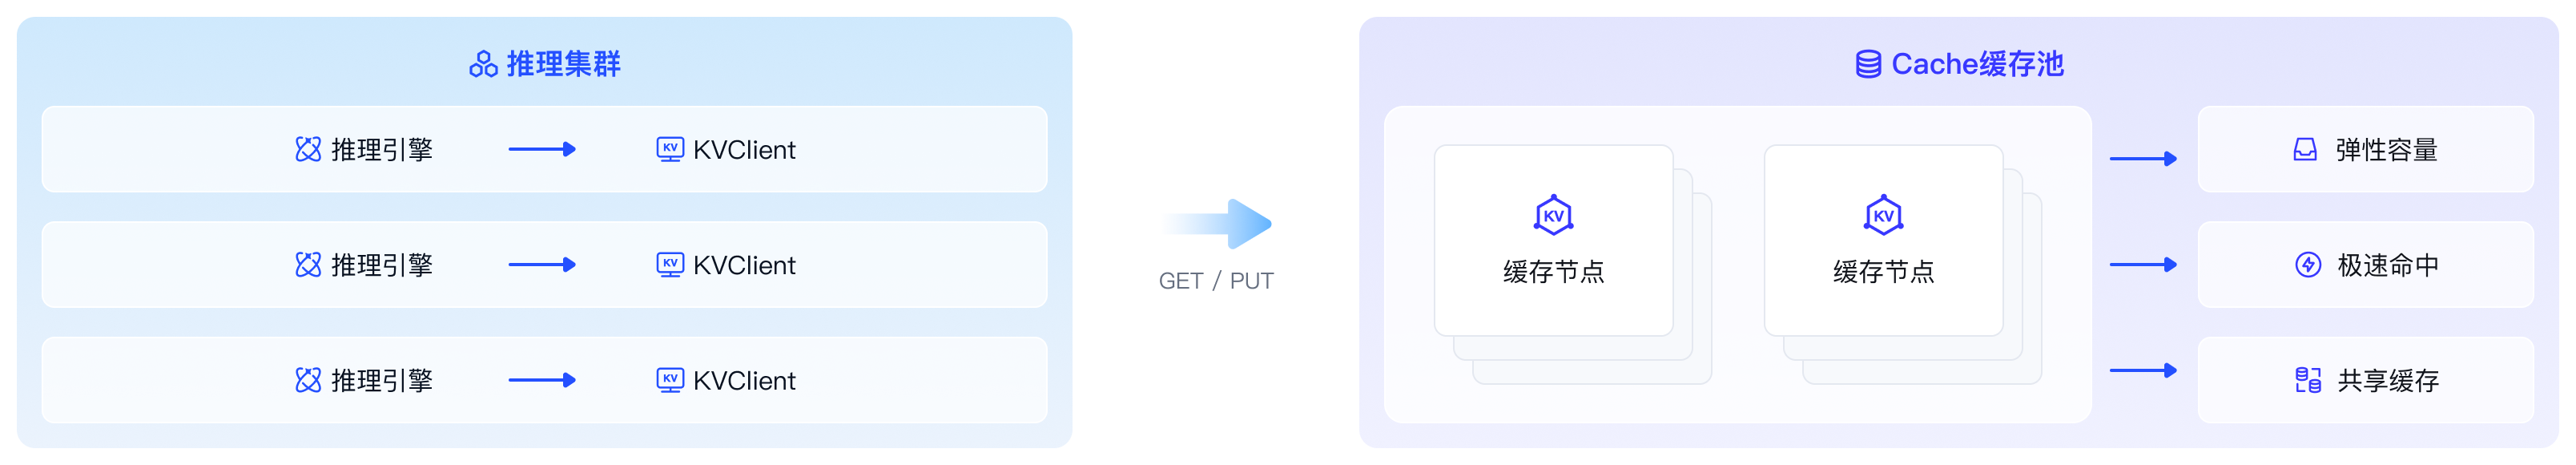
提供面向大模型推理的远端高速缓存池,支持大容量、低时延、高带宽的 KVCache 读写能力。
资源池化共享
支持多个推理实例接入同一共享缓存池,实现 KVCache 容量和前缀复用,降低推理成本。
多服务接入适配
支持接入 Mooncake、SGLang、vLLM 等大模型推理服务系统,适配不同推理服务架构与部署形态。
缓存池实例化管理
用户可按需创建、扩容和释放缓存池实例,独立管理缓存容量,灵活接入推理资源。
产品优势
超大容量,高性能
支持 TB 级到 PB 级缓存容量,兼顾高吞吐与低时延,满足 Agentic 时代长上下文和多轮会话缓存需求。
降低推理成本
以存代算,通过提升 Cache 命中率,减少重复 Prefill 计算,降低 GPU 资源消耗和整体推理成本。
弹性扩容,按需调配
缓存资源实例化管理,可根据业务规模灵活扩展容量,满足用户业务增长需求。
提高资源利用效率
支持多推理集群共享缓存实例,实现容量和吞吐等资源的池化复用,减少碎片化资源浪费。
缓存资源就近访问
支持亲和性调度,优先将缓存资源部署至靠近 GPU 的位置,降低访问延迟,缩小故障域。


